 동현의 나불나불

Process와 thread
process
- 실행되는 애플리케이션 그 자체
- multi process
- 동시에 여러 프로그램을 실행하는 것
- 각 프로세스들은 자신만의 자원, 데이터, 스레드들로 구성되고 공유하지 않는다.
Thread
- 프로그램 실행의 최소 단위
- 모든 process는 하나 이상의 thread로 구성된다
Multi-Thread
- 실제로는 하나의 CPU가 동시에 처리하는 작업은 1개이다.(context switching)
- 아주 짧은 시간동안 여러 thread가 번갈아가면서 수행
Concurrent vs parallel
- concurrent : 하나의 cpu가 여러 작업을 번갈아 가면서 빨리 전환하여 동시에 하는 것처럼 보이는 것
- parallel: 여러 개의 cpu가 각각 자신의 작업을 실제로 동시에 처리하는 것
- 멀티 스레드의 특징을 가진다고 볼 수가 있다.
멀티스레드 프로그래밍의 장단점
- 장점
- CPU의 사용률을 향상
- 작업의 분리로 사용자 응답성 개선
- 자원의 공유를 통해 효율적으로 활용
- 하나의 heap으로 자원을 공유한다.
- 단점
- context switching에 따른 비용이 발생한다.
- 스레드 제어의 어려움
- 동기화 문제
- 데드락
스레드 생성 및 실행
스레드 생성
- 함수형 인터페이스 Runnable 활용
- Runnable 타입의 객체를 thread 생성자 파리미터로 삽입
- Thread 클래스 활용
- runnable을 implements 하고 있다.
- run에 실행 코드 작성
Thread 실행
-
Thread start() 메서드 호출
우리가 작성하는 코드에서는 run()을 직접 넣지 않고 start()를 넣어주어서 run()이 호출 될 수 있도록 준비만 하는 것이 좋다.
start() run()의 관계
- start() : 스레드의 run()이 호출 될 수 있도록 준비만 하는 것
- run() : 준비된 스레드를 실제로 동작시키는 것
- main에서 run()을 직접 호출 하는 것은 thread를 동작시키는 것이 아닌 단순 메서드의 실행
멀티 스레드와 메모리
- 스레드마다 자신의 스택에서 동작
- 메인 스레드가 다른 스레드보다 먼저 종료 가능]
- 모든 thread의 종료가 프로그램의 종료
- start()가 아닌 run()을 호출한다면?
- 별도의 스택을 구성하지 않고 메인 스레드의 스택에서 동작
Thread 상태와 생명주기
작업의 중요도에 따라 우선 순위를 지정한다. setPriority, getPriority를 제공하여 우선순위를 가져오는 것이 가능
MIN_PRIORITY
NORM_PRIORITY
MAX_PRIORITY
이렇게 3가지 상수를 제공한다.
Thread 상태(*)
- NEW: 스레드 객체가 생성 된 후 아직 start()가 호출되지 않은 상태
- RUNNABLE: JVM 선택에 의해 실행가능한 상태
- TERMINATE: run() 메서드의 종료로 소멸된 상태
- WAITING: sleep(),join(),wait() 등에 의해 정해진 시간 없이 대기중인 상태
- TIMED_WAITING : sleep(),join(),wait() 등에 의해 정해진 시간 동안 대기중인 상태
- BLOCKED: 사용하려는 객체의 모니터 락이 풀릴 때까지 기다리는 상
자바중심 회사에서 면접을 보는 경우 기출문제이다.
객체의 라이프 사이클이 있는데 메모리에 올라가면서 중간중간 호출되는 것들을 보여준다.
Thread 제어
-
sleep()
지정된 시간 동안 이 메서드를 호출한 thread는 waiting pool에서 대기
시간이 지나면 waiting pool에서 runnable로 이동
millis동안 동작중인 스레드를 대기풀에서 대기하게 한다.
-
join()
다른 스레드의 작업이 종료될 때까지 대기풀에서 대기
다른 스레드 종료시 ready 상태에서 runnable 상태로 변경후 경합
- yield
- 실행중에 동일한 우선순위를 가진 다른 thread에게 실행을 양보
- 호출한 thread는 blocking 되지 않고 runnable에서 경합한다.
- interrupt()
- waiting pool에서 대기중인 thread를 깨워서 runnable로 이동시킨다.
thread는 run()이 끝나면 자동으로 종료된다. looping 중인 쓰레드를 종료시키려면 interrupt한 상황을 파악해서 안정적인 종료를 유도한다. 한번 종료된 스레드는 다시 start() 될 수가 없다. → IllegalThreadStateException 발생한다.
Daemon Thread
- 일반 thread 작업을 돕는 보조적인 thread
- 일반 thread 모두 종료되는 순간 강제적으로 자동종료
- garbage collector
- 일반적으로 무한 루프를 사용하여 run 이후 대기 상태에 있다가 조건에 따라 실행
공유데이터와 동기화
- synchronized 키워드
- 작업과 관련된 공유 영역에 lock 점검 표시
- 임계 영역에 mutex 설정
- thread t1이 synchronized 만나면 공유 객체의 lock확인
- 있으면 lock을 가져와서 작업
- thread t2도 synchronized 만나면 lock 획득 시도
- lock 얻을수 없으므로 lock pool에서 대기
- t1이 작업을 끝내고 lock을 반환 → t2가 lock pool에서 runnable로 이동
- thread t1이 synchronized 만나면 공유 객체의 lock확인
- synchronized는 한 번에 하나의 스레드만 동작 할 수 있도록 한다.
- 안전하지만 성능상의 문제 발생
- thread의 또다른 고민 - 비효율성
- lock이 걸려있는 상태에서 계속 호출을 하는 것은 리소스 낭비가 된다.
동기화는 최소화하는 것이 좋다. 동기화 메서드를 가져다 쓰는 것도 추천하지 않는다.
Synchronized 관련 메서드
- wait()
- lock을 가진 thread가 더 이상 작업을 수행할 수 없는 상황에서 lock을 풀고 watiting pool로 이동
- notify(), notifyAll()
- wait()로 waiting pool로 이동한 thread들이 활동할 수 있는 조건이 된 경우 호출
- waiting pool에서 대기중인 thread들을 runnable로 이동
쓰레드를 지정하여 깨우는 방법은 존재하지 않는다. wait 된 상태는 queue, stack과 같이 순서가 있는 상태로 저장되는 것이 아니라 waiting set이라고 생각해도 무방
waiting set에 waiting 상태의 쓰레드를 보관한다. 쓰레드는 오는 순서와 내보내는 순서를 저장하지 않는다. this.notify() 자기자신을 깨우는 것은 존재하지 않는다. 깨운 애를 점검을 해야한다.
Thread Pool
- 병렬 작업 증가로 1회성 스레드 개수가 증가하면서 thread 생성, 스케쥴링 비용증가 → 애플리케이션 성능 저하
- Thread pool
- 작업 처리에 사용되는 스레드를 제한된 개수로 정해놓고 작업 큐에 들어오는 작업들을 하나씩 스레드가 처리
- 작업 처리가 끝난 스레드는 다시 작업 큐에서 새로운 작업을 가져와 처리
- 작업의 유형
- Runnable : 작업 후 반환하는 값이 없는 형태
- Callabel 작업 후 반환하는 값이 있는 형태
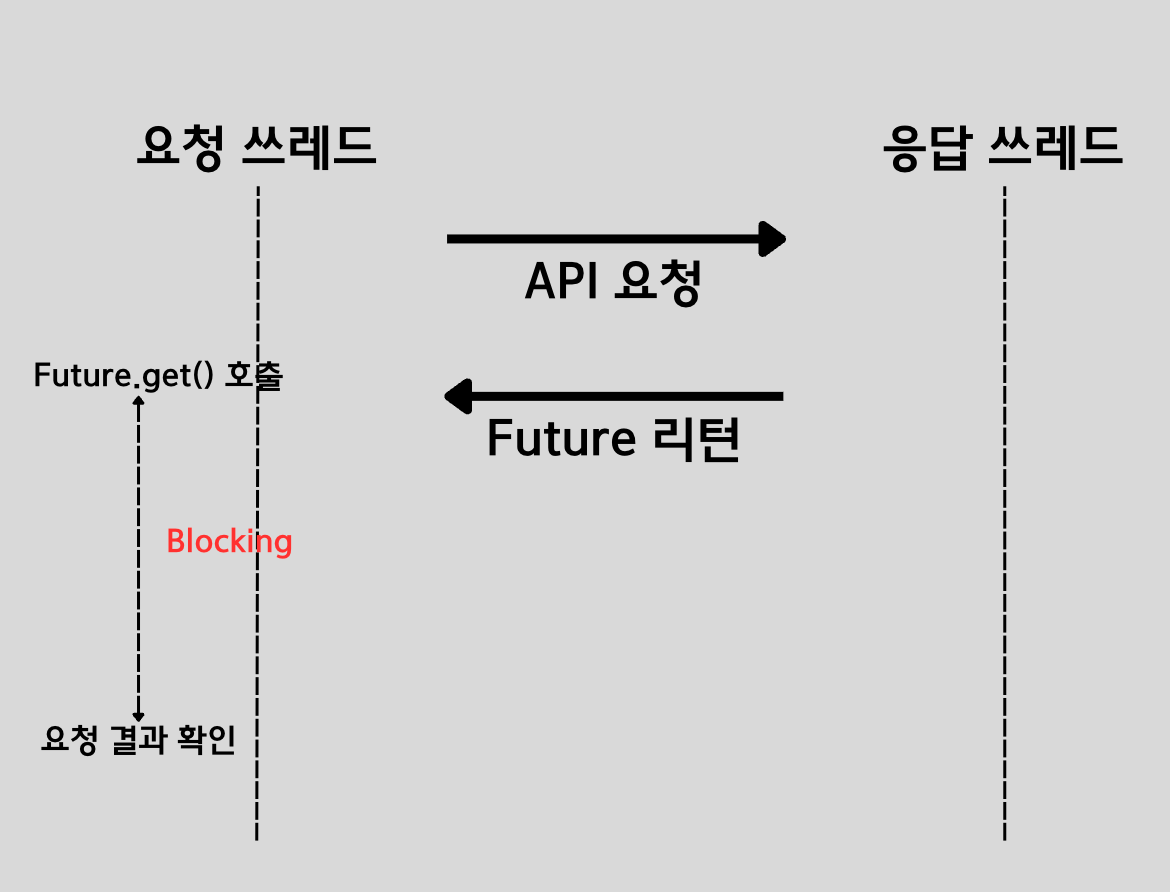
Future(Pending Completion) 지연 완료 객체
- 작업 결과를 호출 즉시 반환하지 않고 작업이 완료될 때까지 블로킹 되었다가 최종결과를 얻기 위한 객체
Completable Future
- Future get()에 의한 블로킹 한계 극복
- Callback 기반의 비동기 처리
//supplyAsync() -> 값을 반환하는 비동기 작업
CompleteableFuture future = CompletableFuture.supplyAsync(()->{return 42;})
// runAsync() -> 값 없는 비동기 작업
CompleteableFuture future = CompletableFuture.runAsync(()->{System.out.println("작업중")})
virtual Thread
- 비용이 매우 저렴한 1회용의 Thread stack 자체를 heap에 구성
- JVM이 관리하는 경량의 Thread 1개의 V.T당 약 수천 수백 byte 소요
- Carrier Thread가 Platform Thread 역할을 수행하며 virtual에 대한 스케쥴링을 담당
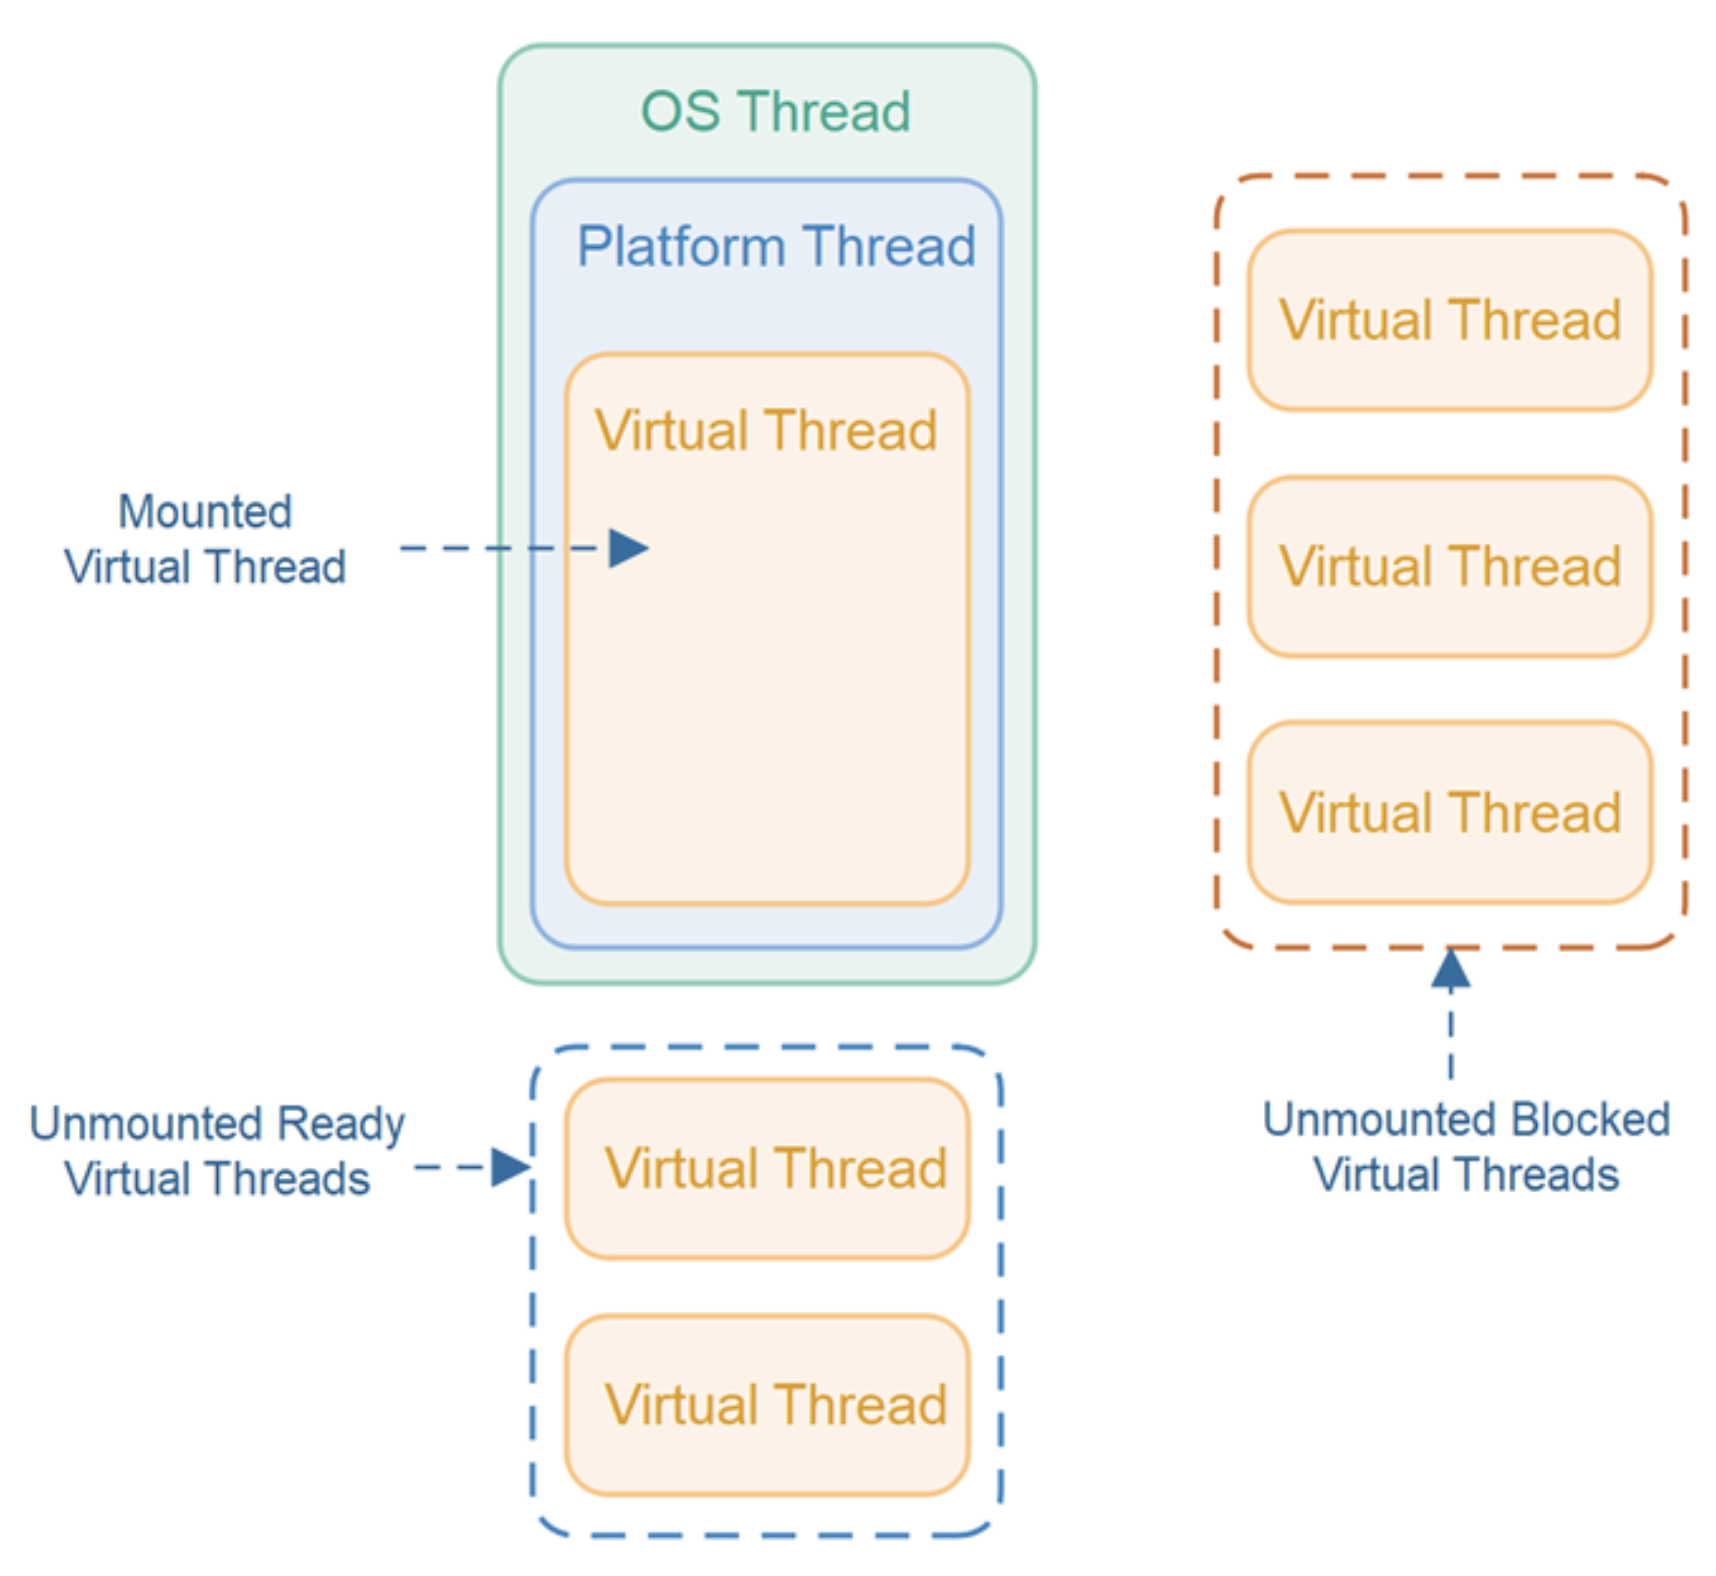
재사용 비용이 크기때문에 threadpool에서 사용하지 않는다. 쓰레드 로컬에서 사용하면 가비지 콜렉션이 과다하게 발생가능하므로 이 경우 일반 쓰레드를 사용하는 것이 좋다.
VO의 주요 목적은 non io blocking이다.,
CPU 작업만 하거나 ContextSwitching이 적은 상황이면 virtual Thread를 사용하지 않는 편이 좋다.
배압(Back Pressure)기능 없다.
배압: 데이터를 생성하는 생산자가 데이터를 소비하는 소비자의 처리능력에 맞춰 데이터 생산 속도를 조절하는 것
DB 처리등 모든 후속 작업들도 위 속도에 맞춰야 하고 지연시 오히려 timeout이 발생한다.