 동현의 나불나불

Thymeleaf
서론
톰캣과 같은 WAS 레벨은 유저가 직접 제어하기 힘들지만 controller 레벨에서는 문제를 인지하고 그 결과를 tomcat에 전달해도 무방하긴 하다.
Dispatcher servlet은 서블렛 클래스이기 때문에 httpServletRequest, httpServletResponse를 받는다. controller에서 httpServletRequest, httpServletResponse에 관한 객체를 주입받아 사용할 수가 있다.
thymeleaf를 사용하면 이 템플렛 엔진은 우선적으로 html 파일을 찾게 된다. 이 @Responsebody에 따라 http 요청 본문에 담긴 값들을 자바 객체로 변환시켜, 객체에 저장을 하고 이를 전달하게 된다.
Thymeleaf 입문
html를 웹에서 보여주는데 spring과 같은 경우는 템플릿 엔진을 사용하게 된다. 이러한 템플릿 엔진을 통해 자바 객체를 html파일에 동적으로 넣어 보내는 것이 가능하다. 스프링 부트에서는 지금 공식적으로 thymeleaf 를 사용한다.
이는 기존의 jsp를 대다수 대체하게 되었는데 그 이유는 다음과 같다.
- jsp보다 빠르다
- html와 관련이 적은 jsp 문법에 대해 배워서 따로 사용하는 할 필요가 없다.
Thymeleaf 적용
<p th:text="${user.name}">기본값</p>
위 문장과 같이 html 태그안에 th: prefix를 추가하여 사용을 하게된다.
Thymeleaf 입장에서는 이를 해석해서 렌더링을 하게 된다.
<p th:text="${content}"></p>

<p th:utext="${content}"></p>
text와 utetxt가 있다. text는 문자열을 그대로 출력하고 utext는 ‘<’와 같은 앵글 브라켓이 존재하는 경우 utext를 활용하다면 unescape 상태로 문자를 넣을 수가 있어서 상황에 맞게 활용해주도록 하자.
주의
댓글, 게시판과 같은 웹의 작성란에 앵글 브라켓에 대해 escaping 문자에 대한 처리를 넣어두지 않는다면 XSS 공격에 대한 취약점으로 될 수가 있다.
<input type="text" th:value="${user.name}" />
user.name의 값이 input value에 들아가게 된다.
<a th:href="@{/users/list}">목록</a>
자동으로 context path 포함
<p th:if="${user != null}">로그인 상태</p>

<p th:unless="${user != null}">비로그인 상태</p>
if else가 아닌 if, not if의 구조인데 조건을 따로 평가하게 된다.
가독성 때문에 unless를 사용하게 된다.
<ul>
  <li th:each="item : ${items}" th:text="${item}"></li>
</ul>
java의 for each와 비슷하게 흘러간다.
서블릿과 같은 경우 Attribute라는 작은 주머니를 가진다. Spring에서는 주머니보다는 모델을 사용하게 된다. 이 모델은 인터페이스이고 스프링 구현체에서 넣어준다.template가 모델 인스턴스를 가져가서 읽어드리게 된다. model에 있는 값을 꺼내서 렌더링을 계속 진행하게 된다.
getMapping 안에 show 라는 것을 선언하게 되었는데 자료구조가 할당되게 된다. addAttribute가 할당된다. 이 addAttribute로 값이 할당되게 된다. 비슷한 공간을 사용한다고 보면 된다.
참고로 thymeleaf에서 랜더링을 할 때는 Object
@GetMapping("/user")
public String show(Model model) {
    model.addAttribute("user", new User());
    return "user-form";
}
이 show가 있는 controller 클래스에서 넣은 값은 Thymeleaf 템플릿에서 활용하게 된다.
<p th:text="${user.name}">이름</p>
Thymeleaf에서 폼을 다루거나 랜더링을 할 때 th:object를 활용한다.
먼저 폼을 다루는 경우 객체단위로 바인딩을 하게된다.
<form th:action="@{/user}" th:object="${user}" method="post">
    <input type="text" th:field="*{name}" />
    <input type="text" th:field="*{age}" />
    <button type="submit">전송</button>
</form>
특정 객체를 기준으로 데이터를 참조할 때 사용하고 하위 태그가 이 객체를 기본 참조 대상으로 활용하게 된다.
한마디로 th:object는 기준 객체를 설정하고, *{}는 그 객체의 프로퍼티에 직접 접근하기 위한 문법이라고 볼 수가 있다.
프로젝트를 구성하는 웹을 구조적으로 설계하고 각 계층에 맞게 접근하기 위해서는 동적인 url을 작성해줘야 한다. url과 uri를 REST하게 설계를 했다면 식별가능한 path를 부여받는다.
앵커 태그에다가 url을 동적으로 생성할 수 있게 설계하고 반복문
<a th:href="@{/users/{id}(id=${user.id})}">상세보기</a>
아래의 경우 tx:text를 쓸때 중괄호에 Original Text가 대체되는 형식으로 돌아가게 된다.
th:text에 파이프 기호를 쓰고 일반텍스트를 쓰고 중괄호롤 넣어 최종적으로 돌아가서 문자열이 대체가 된다. 문자열 + 변수와 함께 사용하고 싶을때 사용한다.
<p th:text="|이름: ${user.name}|">Original Text</p>
java에서 js로 데이터를 넘기고 사용하는 방법이다. js를 사용할 때 보는것이 alert이다.
<script th:inline="javascript">
    const username = [[${user.name}]];
    alert(username);
</script>
js는 이를 주석으로 인식하고 thymeleaf는 주석안의 값을 활용하는 것이 가능하다. java에 있는 값을 js에 넣어 보내고 싶다면 주석을 활용하면 된다. 주석에다가 thymeleaf 표현식을 넣어주면 js가 생각하지 않고 넘기게 된다. 그러면 thymeleaf가 주석을 제거하고 받아드린다.
<script>
    const name = /*[[${user.name}]]*/ "default";
</script>
참고 : 템플릿 엔진 설정
yaml
    spring:
    thymeleaf:
        prefix: classpath:/custom/
        suffix: .txt
이렇게 간단하게 템플릿엔진의 과정을 바꾸는 것을 몇 안되는 문장으로 가능하다. spring boot의 추상화가 되어있기 때문이다. spring boot에서 template 아래의 index.html을 두면 따로 랜더링을 하지 않아도 실행된다. @RequestParam 붙인 것은 Parameter로 반환된다.
프로젝트 방법론
애자일
소프트웨어의 개발 방식의 하나로 변화에 유연하게 대응하면서, 짧은 주기로 가치를 계속 전달하는 방식이다. 우선 작게 만들고 빠르게 검증하고 계속 개선하는 과정을 반복한다.
다음과 같은 애자일 선언문을 기반으로 한다.
«애자일 선언문»
우리는 소프트웨어를 개발하고, 또 다른 사람의 개발을 도와주며 소프트웨어 개발의 더 낳은 방법들을 찾아가고 있다.
이 작업을 통해 우리는 다음을 가치있게 여긴다.
1. 공정과 도구보다 개인과 상호작용을 가치있게 여긴다.
2. 포괄적인 문서보다 작동하는 소프트웨어를 가치있게 여긴다.
3. 계약, 협상 보다 고객과의 협력을 가치있게 여긴다.
4. 계획을 따르기 보다 변화에 대응하기를 가치있게 여긴다.
- 짧은 주기의 개발 단위(스프린트)를 반복하여 하나의 큰 프로젝트를 완성해 나가는 방식이다.
- 애자일의 핵심은 피드백과 협력이다. (협력과 피드백을 자주, 빨리)
- 애자일은 방법론이 아니다.
- 애자일은 협업과 워크플로우를 바라보는 관점, 문화, 사상이다.
- 이러한 애자일을 계승하여 나온것이 칸반, 스크럼, WBS등이 있다.
스프린트
애자일 스크럼에서 사용하는 개념으로 짧은 시간 동안 목표 기능을 완성하는 개발 사이클이다.
보통 1~2주 단위로 진행되고 작게 만들고 -> 바로 검증 -> 수정 -> 반복을 반복한다
- SprintPlanning
이번 스프린트에서 할 일 결정 - Development
실제 개발 진행, 기능 구현 - Daily Scrum
어제 한 일, 오늘 할 일, 문제점을 짧게 공유 - Sprint Review
결과물 시연 - Sprint Retrospective
잘한점, 문제점, 개선 방법을 도출하여 다음 스프린트 반영
제품의 작동하는 부분을 제공하기 위해 중점을 둔다.
유저 스토리
사용자 입장에서 기능을 설명하는 짧은 요구사항 문장이다. 이 기능을 누가, 왜 사용하는가에 집중한다. 단순 기능 설명이 아니라 사용자의 목적까지 포함해서 기술한다.
As a [사용자],
I want [기능],
So that [이유/목적]
사용자 중심으로 사고하게 만들어 쓸모없는 기능을 감소하고 우선순위 명확해지고 협업이 쉬워진다.
참고 :
프로젝트에서 난관에 마주친 부분이 있으면
트러블 슈팅 관련 문서 작성하는 것이 중요
협업을 위한 github 기능
github organization
GitHub에서 여러 리포지토리(repository)와 멤버들을 관리하는 공동 작업 공간을 의미한다.
조직 계정은 팀 협업에 최적화된다. 각 멤버는 특정 권한을 갖고 프로젝트에 접근가능하다.
기능
- 리포지토리 관리: 조직 내에서 여러 프로젝트를 각각의 리포지토리로 관리할 수 있다. 조직 소속 리포지토리는 조직에 속하며, 개인 사용자에 귀속되지 않는다.
- 팀 관리: 조직 내에서 팀을 만들어 특정 리포지토리나 프로젝트에 대한 권한을 부여할 수 있다. 예를 들어, 개발 팀, QA 팀 등으로 나누어 각 팀에 다른 권한을 설정할 수 있다.
- 권한 관리: 리포지토리나 팀 단위로 접근 권한을 세밀하게 조정할 수 있다. 특정 사용자에게는 읽기 전용 권한을, 다른 사용자에게는 쓰기 권한을 줄 수 있다.
- 지속적인 통합(CI/CD) 도구 연동: 조직은 빌드 및 테스트 자동화를 위한 다양한 도구(CI/CD 도구)와 쉽게 연동할 수 있어, 팀 전체의 효율성을 높인다.
github project, karban
사용자 또는 조직 수준에서 작업을 효과적으로 계획하고 추적할 수 있도록 GitHub의 이슈 및 끌어오기 요청과 통합되는 조정 가능한 테이블, 보드, 로드맵를 제공한다.
여기에 대한 entity를 뽑고 견적을 낼 줄 알아야한다. 흔히 사용하는 템플릿으로 karban보드가 있는데 backlog, Ready, In Progress, In review, Done, Documents와 같이 과정이 분리가 되어 있다. 각 과정에 맞게 일을 배치하고 이동시켜야 한다.
backlog는 개발해야 할 기능 or 제품에서 요구하는 사항 기능 및 우선순위를 기록한다.
여기서 주의해야 하는 점이 In progress에 끝낸 작업이더라도 팀원과의 리뷰를 할 것을 In review로 옮기고 검수를 하여 Done으로 이동시켜야 한다.
이렇게 작업을 해두면 시간이 지난 후에 문제가 발생한 경우 tracing을 하고 작업을 열어봐야 한다.
github issue
작업의 버그 수정, 새로 추가해야 할 기능, 개선해야 할 기능 등 모든 것을 관리하는 곳이다. 모든 활동 내역에 대해 이슈를 등록하고 이를 기반으로 작업을 진행한다.
issue 문서에는 다음과 같은 정보가 기록된다.
- assignee : 작업이 할당된 사항
- projects :개발의 우선순위를 정하게 된다
- size : 작업의 규모를 뜻하게 된다.
- 작업의 규모에 따라 붙을 사람이 정해져 있기 때문에 M에서 크게 벗어나지 않는다
- estimate : 내가 할 수 있는 일이 10이 있다면 어느정도 이 작업에서 소모할 것인지 기록한 것이다.
- startDate : 시작 일
- TargetDate : 끝나는 일
참고 :
코드리뷰 문서도 포트폴리오에 활용할 좋은 자산이 되니까
버리지 말것
협업을 위한 브랜치 관리 및 코드리뷰
최초 브랜치로부터 stage와 dev라는 브랜치가 나오게 되는데 우리가 본격적으로 고객들에게 우리의 서비스를 공개하는 것을 배포라고 한다. 이 배포된 것을 기반으로 제공하는 것을 production이라고 한다.
우리는 repository라는 origin branch를 갖는다. 그리고 개발 전용 브랜치인 dev 브랜치를 만들게 된다. 우리는 push를 dev에 바로하면 안된다. 일단 각자의 브랜치를 합치고 개발서버에 일단 실행을 한다.
스태이지는 프로덕트에 들어가기전에 배포환경이랑 동일한 환경에서 테스트를 거치게 되는데
문제가 있는지 검수를 하게 되고 날짜가 지나면 스테이지랑 합치게 된다.
dev 브랜치가 생겼으면 메인 브랜치를 쓰는 것이 아니다. 이제는 dev가 메인 브랜치이다.
또한 브랜치는 폴더라는 것이 없다. 논리를 표현할 때는 상하 관계를 쓰게 된다.
피쳐브랜치와 같은 경우 jira 티켓과 같은 것을 붙이게 된다. m001 작업이라고 하면
dev를 기준으로 브랜치를 만들게 된다. m001-mdh 이런 식으로 본인브랜치에다가 본인 작업을 붙인다. 하루를 정하고 모두가 모여서 pr을 날린다(pull request)에 날린다. dev에 이때 코드리뷰 들어가게 된다.
만약 이때 CI/CD를 걸어두면 실행가능한지에 대한 테스트를 거친다. 만약 테스트를 통과하지 못하게 되면 규격외 코드가 된다. 지금은 ci/cd 스크립트를 배우지 않아 적용을 하지 않는다.
이 경우 합치면 각자 브랜치에서 작업한 모든 브랜치의 히스토리가 다 dev에 들어가게 된다.
이렇게 반영을 하는 것을 버전이 올라간다고 표현할 수가 있다.
이것이 가장 기본체계이다.
작업을 pull request에 올리면 issue처럼 코멘트를 달 수가 있는데 이 경우 건설적으로 다는 것이 좋을 수가 있다. 예를 들어, 그런 방향도 좋지만 이런 문제도 발생할 수 있는데
이걸 이렇게 하면 어떻게 하는게 좋지 않을까요? 이런 식으로 다는 것이 좋다.
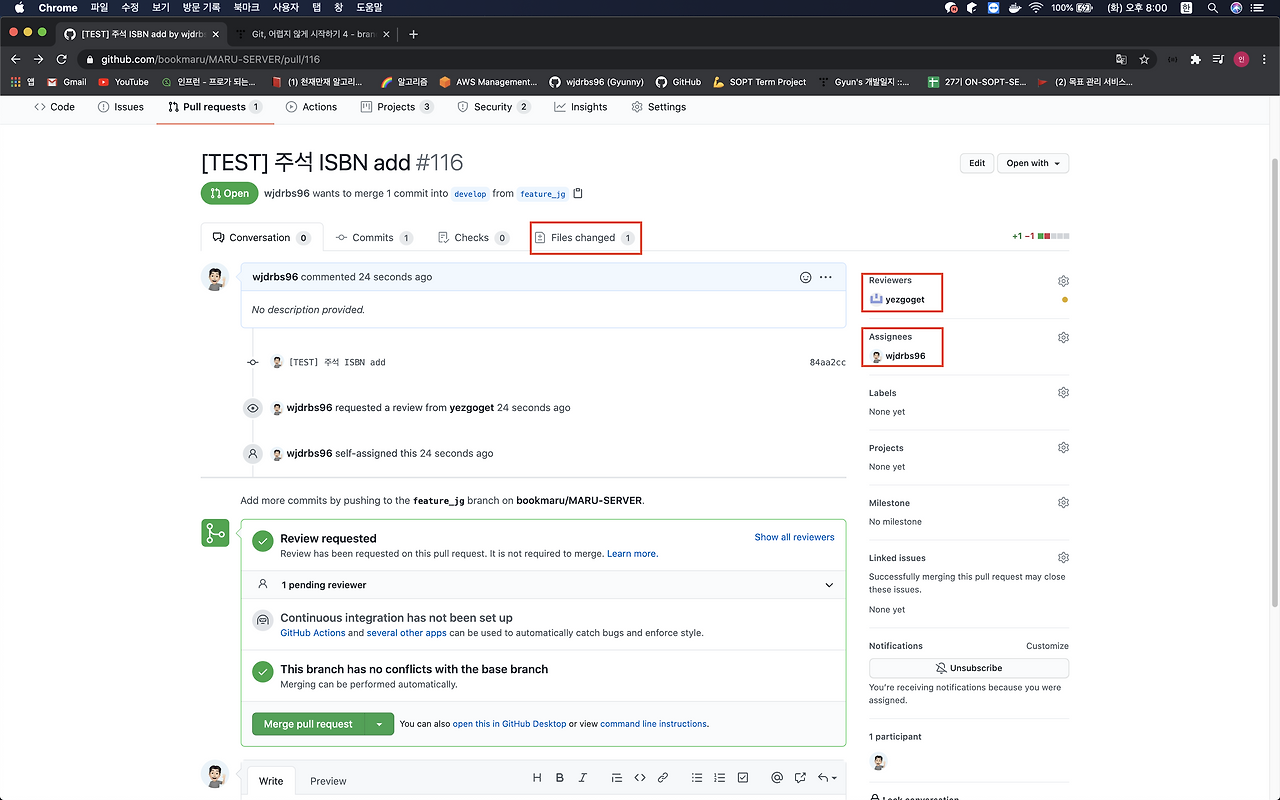
또한 만약 코드리뷰를 닫지 말고 새로운 커밋메시지를 푸쉬한다면 밑에 댓글처럼 적히게 되고
바로바로 반영이 된다. 이렇게 계속 채워나갔다가 완료를 받게 된다면 #을 누른다면 작업 브랜치를 걸 수가 있다. 그리고 프로젝트에서 이 코드리뷰에 들어가는 것이 가능하다.
layered architectrue
애플리케이션을 역할별로 여러 계층으로 나누는 설계방식을 의미한다.
함께 기능하는 여러 개별 layer로 이루어져 있고 각 layer을 특정 역할 및 관심사 별로 구분을 하고 배치하게 된다.
Spring의 경우에는 Controller -> Service -> Repository -> Database 이런식으로
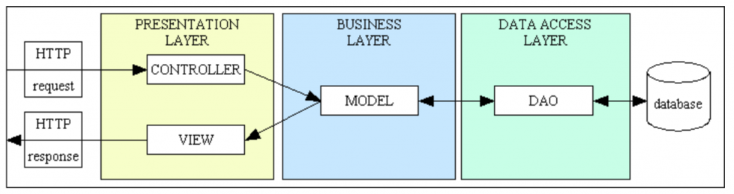
출처 : https://velog.io/@jhp1115/3-tier-Layered-Architecture와-MVC
Model은 데이터와 관련된 부분이다. 데이터와 비즈니스 로직을 관리한다. 그렇다면 비즈니스 로직에 맞춰서 데이터를 처리하는 Business(Domain) Layer에 속할 것이다.
View는 사용자에게 보여지는 부분이다. 그렇기에 사용자와의 상호작용을 통해서 정보를 표시해주고 정보를 가져오는 Presentation Layer에 속할 것이다.
Controller는 사용자의 입력된 Domain을 DTO로 변환하는 등의 처리하고 Model과 View를 이어줘야 하기 때문에 Presentation Layer에 속할 것이다.
장점
- 관심사의 분리 : 각 개별 구성 요소의 단일 책임을 보장이 가능하다. ( 종속성 저하 )
- 개발하기 쉬움 : 구현할 아키텍처 패턴이 확실치 않은 경우 좋은 출발점이 될 수 있다.
- 테스트가 쉬움 : 모든 Layer가 개별적이라서 단위 테스트로 커버될 수 있고 특정 Layer에 속한 구성요소도 분리되어 있어 개별적 테스트가 가능하다.
- 격리 : 각 Layer가 다른 Layer와 독립적이어서 변경 사항이 다른 Layer로 영향을 끼치지 않는다.
단점
- 확장성 : 애플리케이션 복잡도가 증가하고 프로젝트에 더 많은 기능을 추가해야하는 경우 확장하는데 비용이 크다. (모놀리식 구현 경향)
- 상호 의존성 : 하나의 계층이 데이터 수신을 위해선 상위 Layer에 의존하기에 상호 의존성이 존재한다.
- 배포 : 특정 Layer에 대한 변경은 전체 시스템을 재배포해야 함을 의미한다. ( 큰 Application의 경우 더 문제가 된다. )
- 성능 : 비즈니스 요청을 이행하기 위해 Architecture의 여러 Layer를 거쳐야 하는 비효율성으로 인해 고성능 Appication에 적합하지 않다. (병렬처리가 불가능)