 동현의 나불나불

Batch Process 일괄 처리 방식
Batch는 일정량의 작업을 모아서 한번에 처리하는 방식이다.
대량의 쿼리를 실시간으로 계속 처리한다면 서버 부하 증가, 응답 속도 저하와 같은 부작용이 있기때문에 모아서 작업을 할 필요성이 생긴다고 할 수가 있다.
벌크 쿼리
단순히 하나, 두개의 쿼리가 아닌 여러 개의 쿼리
public List<Item> saveAll(List<Item> items){
        //batch
        final int BATCH_SIZE = 50;

        for (int i = 0; i< items.size(); i++){

            entityManager.persist(items.get(i));
            if(i % BATCH_SIZE ==0 && i>0){
                entityManager.flush();
                entityManager.clear();
                log.info("FLUSH :)");
            }
        }

        entityManager.flush();
        entityManager.clear();
        log.info("FLUSH :)");

        return items;
    }
배치 크기로 flush를 반영을 하고 java에는 생성자는 있지만 소멸자는 없기 때문에 객체 정보를 삭제해주기 위해서 clear() 메서드를 사용해 영속성 컨텍스트를 비워준다.
예를 들어 만약 275개의 데이터가 있고 현 배치크기는 50이기 때문에 반복문만 사용한다면 나머지 25개의 데이터에 대해 처리를 해주지 않는다.
이 때문에 나머지 데이터에 대해 처리를 해주기 위해 밖에서 한번더 flush()와 clear()를 해주게 된다.
@Test
    void it_will_save_all(){
        int SIZE = 1_000;
        List<Item> items = generateItemList(SIZE);

        List<Item> savedList = repository.saveAll(items);
        assertThat(savedList.size()).isEqualTo(SIZE);

        savedList.forEach(
                item -> assertThat(item.getId()).isNotNull()
        );

        List<Item> items1 = repository.findAll();
        log.info("items1.size()={}", items1.size());
    }
Reflection
jpa에서는 persist, remove, update같은 작업을 하게되는데 이 작업이 끝나면 java객체가 사라지는 것이 아니다. DB의 row가 사리지는 것이지 java객체는 여전히 jvm에 살아있다.
그리고 java에는 reflection이라는 기술이 있는데 이는 런타임 시점에 클래스 정보를 동적으로 분석하는 기술이다.
findByNameAndPrice()
이런 메서드가 있으면 Reflection으로
find find → SELECT, delete → DELETE, save → Insert
By
Name
And
Price
메서드 명을 사용하여 사용자에 맞게 동적으로 쿼리를 구현하는 것이 가능하다.
이는 프록시가 메서드 호출을 감지하고 reflection을 통해 메서드 이름을 분석하고 그에 맞는 JPQL을 생성하여 Hibernate에 넘겨주는 것과 같다. 이러한 기능을 Query Method라고 한다.
조건이 복잡해지면 QueryDSL을 사용하게 된다.
Spring Data JPA
앞에서 언급한 방식으로 repository를 구현할 수도 있지만 Spring Data JPA에서 지원해주는 인터페이스가 있다.
JpaRepository<T, ID>
- T : 엔티티 클래스의 타입
- ID : T의 식별자가 될 PK의 타입
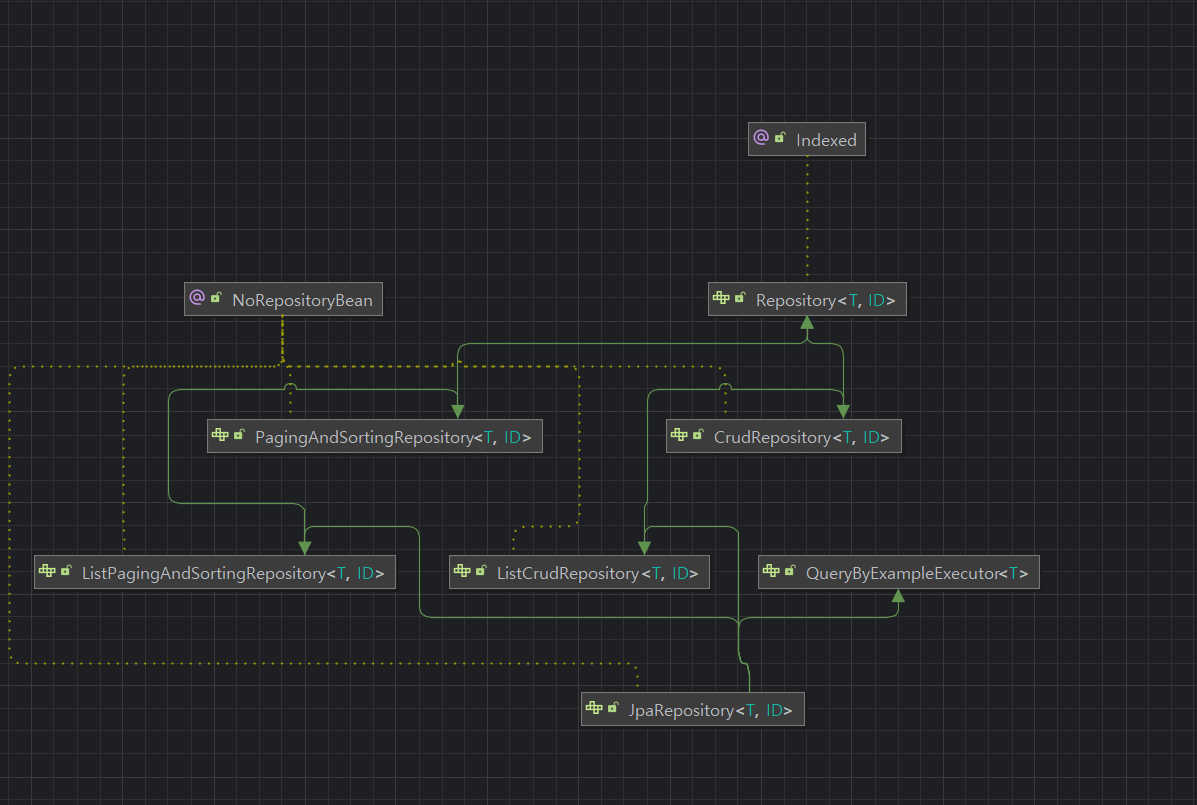
CrudRepository에서 우리가 사용해온 saveAll, delete, findById 등의 CRUD 기능을 제공해준다.
PagingAndSortingRepository에서는 페이징 기능을 제공해준다.
페이징의 장점 : oom(Out of Memory) 을 막고 가독성과 속도를 개선 한다
페이징이 필요한 이유
단순히 화면 가독성 기능 뿐만 아니라 성능 최적화 기술을 제공해준다.
만약 데이터가 100만 건의 대용량인 경우 전부 가져오면 메모리 사용량 증가, 속도 저하등 문제가 생길 우려가 있다. 하지만 페이징을 통해 다음 페이지를 지연조회, 부분조회를 하여 성능저하를 줄일 수가 있다.
@DataJpaTest
만약 Repository만 검증하고 싶은데 Repository의 기능을 테스트하기 위해서는 컨트롤러, 서비스,보안 설정, 웹 설정 등을 띄우게 되면 테스트의 속도가 느려지고 불필요한 bean을 올리게 되어 테스트의 목적이 흐려진다.
이와 같은 경우를 생각해 spring boot에서 제공해주는 테스트 어노테이션이 있는데 대표적인 예시가 @DataJpaTest이다. 이 어노테이션을 사용하면
Repository Bean, EntityManager, Hibernate ,JPA Auditing 관련 구성, DataSource, 등 데이터 접근 계층에 필요한 Bean만 로딩된다.
Controller,Service,Security, Web MVC 설정,ViewResolver 같은 Bean들은 기본적으로 제외된다.
즉, DB 접근과 관련된 최소한의 스프링 컨텍스트만 실행된다. 그렇게 되어 테스트 속도를 향상시키고 메모리 절약, 테스트 목적 명확화 등의 장점을 갖게된다.
참고
단축키 : shift + shift 원하는 클래스로 이동하는 것이 가능하다
디버깅
기존의 일반 hibernate, mybatis와 다르게 spring data JPA는 너무 추상화가 잘되어있어 사용하기는 편리하지만 버그가 생겼을경우 어떤곳에서 문제가 발생했는지 체크하기가 힘들어진다.
여기서는 breakpoint를 활용할 수가 있다. 그리고 breakpoint를 걸고 디버그 모드로 실행하면 프로그램은 해당 줄에서 멈추게 된다.
step 기능 사용하기
- step over : 현재 줄을 실행하고 다음 줄로 이동
- step into : 현재 줄의 메서드 내부로 이동
- step out : 현재 들어와 있는 메서드를 빠져나간다
- resume : 다음 breakpoint까지 실행한다.
디버그와 로그는 함께 사용하는 것이 좋다. 그리고 Controller → Service → Repository 호출부 → Entity 값 → SQL 로그의 순으로 확인을 하면 좋을 것 같다.
Spring Boot Mybatis와 그냥 MyBatis의 차이
MyBatis에서 개발자가 직접 xml파일에서 DataSource설정, SQLSessionFactory, Mapper등록 등 여러가지 설정을 수동으로 했지만 Spring Boot Mybatis에서는 Dependency만 추가하면 Spring Boot가 내부적으로 DataSource 생성, SqlSessionFactory 생성, Mapper 스캔, 트랜잭션 연결, Connection Pool 설정 등을 자동 처리해준다.
필요한 사항은 application.yml이나 application.properties에 적은 DB정보를 기반으로 자동으로 DataSource Bean을 생성하게 된다.
DSL(Domain Specific Language)
특정 도메인을 대상으로 만들어진 특수언어, 특정 비지니스 도메인을 인터페이스로 만든 API라고 봐도 무방하다. Stream, Collector 등도 DSL이라고 할 수가 있다. 대표적으로 SQL, html이 존재한다.
QueryDSL의 경우 Java코드로 쿼리를 작성하기 위한 DSL이라고 볼 수가 있는데 이는 SQL과 비슷한 의미를 Java 코드로 구현한다.
DSL은 크게 External DSL, Internal DSL이 존재한다.
External DSL은 독립적인 문법을 가진 DSL이다. 대표적인 예시는 SQL이다. 도메인을 매우 자연스럽게 표현할 수 있는 장점을 가지고 단점으로는 별도의 문법을 배워야 한다.
Internal DSL은 기존 프로그래밍 언어 안에서 만들어지는 DSL이다. 예시로는 QueryDSL, Gradle이 있다. QueryDSL는 Java 안에서 사용하는 Internal DSL이고 gradle은 groovy,kotlin기반 Internal DSL이다.