 동현의 나불나불

Mybatis 보충
mybatis를 사용하면서 개인적으로 놓친 부분이라서 다시 공부를 해야겠다.
resultType과 resultMap
mybatis는 xml -> namespace(인터페이스) 확인-> SQL 내부 저장 -> getMapper()호출 -> 인터페이스 기반의 프록시 생성 -> 메서드 호출시 SQL 실행이라는 과정을 거치게 되는데 xml파일에서 쿼리를 작성하고 이에 관한 값을 java 파일에서 사용을 할지 아니면 xml파일 내 다른 구문에 전달을 할 지를 결정하게 된다.
이때 자바객체로 반환을 할 경우 resultType, xml에서 지정한 파일로 넘기고 싶을때는 resultMap을 사용하여 넘기게 된다. 이때의 resultMap은 java가 xml에서 작업한 join 쿼리와 같은 결과물들을 인식하도록 하는 설계도가 된다.
예제코드
<resultMap id="memberDtoResultMap" type="domain.MemberDto">

    <id property="memberId" column="member_id" />

    <result property="memberName" column="member_name" />
    <result property="memberBalance" column="member_balance" />

</resultMap>

<select id="findAll" resultMap="memberDtoResultMap">
    SELECT
        id AS member_id,
        name AS member_name,
        balance AS member_balance
    FROM
        member
</select>
위 코드는 interface로 만든 MemberDTO 타입의 결과를 전송하기 위해 매핑한 resultMap과 member정보를 DTO로 반환할 select 쿼리를 가져온 것이다.
<select id="findById" parameterType="long" resultType="domain.Member">
        SELECT
            id,
            name,
            email,
            balance
        FROM
            member
        WHERE
            id = #{id}
    </select>
여기서 resultType에 domain 패키지의 Member로 타입을 변경하여 반환하는 것이다. 그리고 여기서 parameterType은 findById에 어떤 타입의 파라미터가 들어왔을 때 시행할 것인지를 명세화한 것이다.
Mybatis에서의 cache
mybatis에서 성능 최적화를 위한 기능이다. 같은 SQL 결과를 내부 메모리에 저장해두고 재사용을 해서 DB조회를 줄이는 기능이다. 실제로 실행시켜 보면 캐시를 사용한 경우 SQL문을 읽지 않고 동일한 결과가 나옴을 알 수가 있다.
DB와 상호작용하는 작업 단위 객체인 Session를 단위로 하는 1차 캐시(local cache) mapper 단위의 2차캐시(second level cache)가 존재한다.
이 cache는 commit(), rollback(), close(), INSERT, UPDATE, DELETE, 데이터 변경과 같은 경우 초기화를 하게 된다.
Mybatis에서의 1차캐시(Local cache)
1차 캐시는 같은 세션 내에서 동일한 쿼리를 재사용하는 기능이다. 여기서 사용하는 세션은 SqlSession으로 같은 쿼리 + 같은 파라미터를 가지는 경우 캐시가 이루어진다. 하지만 같은 세션 내 다른 객체로 설정해 놓은 Member m1, Member m2를 파라미터 1로 조회하는 경우 캐시가 같은 객체로 취급을 하게된다. 이 때문에 여러 트랜잭션이 존재하는 큰 시스템에서 데이터 정합성 때문에 사용을 조심해야 하고 캐시에 의존하지 말고 DB기준으로 생각해야 한다.
Mybatis에서의 2차 캐시(Second level cache)
2차 캐시는 Mapper 단위로 여러 SqlSession 간 공유되는 캐시이다.
세션단위로 불러오는 결과가 commit되는 경우 이를 2차 캐시에 저장하여 활용할 수가 있다.
2차 캐시에 객체를 저장하려면 java의 Serializable 인터페이스를 사용해 직렬화를 할 필요가 있다. 직렬화를 통해 객체를 바이트화를 하고 바이트화 된 값을 객체로 바꾸는 역직렬화 과정을 거쳐 캐시에서 빼내 반환을 하게 된다. 만약 readOnly 모드로만 사용한다면 직렬화 과정을 거칠 필요는 없다.
직렬화를 하는 이유는
<cache
    eviction="LRU"
    flushInterval="60000"
    size="512"
    readOnly="true"/>
여기서 eviction은 cache를 관리하는 방법을 설정하는 것이고 FIFO, LRU 등 os의 메모리를 관리해주는 방법을 가져왔다. 흔히 LRU로 사용한다고 한다. flushInterval은 캐시가 초기화되는 시간을 설정하는 것이다. 정해진 시간이 지나면 캐시는 초기화된다. size는 캐시의 크기를 의미하고 readOnly는 읽기전용인지 아닌지를 설정한다. 만약 읽기 전용으로 설정할 시 성능이 올라간다.
Cache Hit Ratio [mapper.s5.ProductCacheMapper]: 0.5
전체 조회중 절반은 캐시에서 가져왔고 절반은 DB에서 가져왔다는 의미 , Hit ratio = 캐시 적중 횟수/ 전체 조회 횟수를 의미하고 이 cache Hit Ratio를 통해 캐시를 얼마나 효율적으로 사용하는지 볼 수가 있다.
sql join 복습
여러 테이블이 존재할 때 테이블간의 join이 이루어지는 과정
    <select id = "findAllOrder" resultMap="orderFullMap">
        SELECT
            o.id AS order_id,
            o.member,
            o.ordered_at,
            o.status,
            m.id AS m_id,
            m.name AS m_name,
            m.email AS m_email,
            m.balance AS m_balance,
            oi.id AS oi_id,
            oi.order_id AS oi_order_id,
            oi.product_id AS oi_product_id,
            oi.quantity AS oi_quantity,
            oi.price AS oi_price,
            p.id AS p_id,
            p.name AS p_name,
            p.price AS p_price,
            p.stock AS p_stock
        FROM
            orders o
        JOIN  member m ON o.member_id = m.id
        JOIN  order_item oi ON o.id = oi.order_id
        JOIN  product p ON oi.procuct_id = p.id
    </select>
이렇게 여러 테이블을 가져오는 경우 SQL에서 작성된 순서대로 JOIN이 진행된다. order -> member -> order_item -> product 순으로 진행이 이루어진다. 하지만 sql 옵티마이저에 의해 순서가 바뀔 수가 있는데 확인을 해보고 싶다면 Explain문을 사용하여 알아보도록 하자.
기준테이블 -> ToOne -> ToMany -> 추가 확장을 거치게 되서 권장되는 순서를 지킨다고 볼 수가 있다.
JAVA에서의 ORM 구성
서론
JDBC가 java와 SQL의 연결을 하여 java에서 데이터베이스를 사용할 수 있었지만 시간이 지날 수록 JDBC의 단점 중 하나인 불필요한 반복을 CRUD의 쿼리를 작성하는데 많이 느끼게 되었다.
SQL에서는 join으로 해결할 수 있었던 문제를 java에서는 연관관계에 되어 있는 객체를 가져올 방법은 없어서 다른 방법을 사용해주어야 했다. 이를 위해서 sql로 직접 쿼리를 작성해야 하는 것도 문제가 되었다. 자바의 가장 큰 장점은 객체지향인데 sql을 직접 쿼리를 작성해서 사용하면 sql에 의존적인 프로그램을 짤 수 밖에 없다는 것이 이전의 JDBC 구조의 단점이다.
그리고 관계형 데이터베이스에서 새로운 컬럼을 추가하는 경우 그 컬럼에는 null값이 추가된다. 그리고 데이터베이스만 바뀌는 것은 상관없는데 복잡한 프로그램에서는 그 테이블의 데이터를 쓰는 코드를 다 바꾸어야 하는 문제로 확장될 수가 있다.
이러한 차이를 극복하기 위해 사용하는 기술이 ORM이다.
ORM(Object Relational Mapping)이란?
ORM은 관계형 데이터베이스와 java 객체 사이에서 relation을 매핑해주는 기술이다.
테이블이 완전 객체로 바뀌고 참조의 참조를 하는 것이 가능하다. 그리고 xml 파일이 없기 때문에 쿼리도 ORM으로 만드는 것이 가능하다. 객체 위주로 데이터베이스를 관리하는 것이 가능해진다.
- 장점
- 개발자가 SQL에 의존하지 않고 비지니스 로직을 구성하는 것이 가능
- 단점
- SQL이 객체입장만 고려하고 객체에만 의존하여 SQL이 복잡해질 수가 있다
- DB가 개판이 될 수 있는 우려가 있다.
- → 그래서 DB와 객체 구조 모두 고려해야 한다.
JPA(Java Persistence API)
영속적으로 제공 ORM은 개념, ORM을 사용하기 위한 표준 인터페이스가 JPA이다.
JPA는 자바의 ORM 기술 표준이자 명세이다. 표준 인터페이스로 제공하고 있어서 JPA만 implement를 한다면 java에서 사용가능하고 다른 JPA 기술을 적용하기 쉬워지고 생산성이 올라간다. 테이블의 명세를 hybernate가 읽어내려서 스키마를 대신 생성까지 대신 해주는 것이 가능하다.
@Entity
class Member {
    @Id
    Long id;
    String name;
}
위 코드와 같이 객체로 테이블을 구성하는 것이 가능하다.
JPA를 사용하는 이유
xml의 변경시 java 코드를 변경을 해줘야 하기 때문에 entity 객체에 대한 신뢰도를 떨어뜨린다고 볼 수가 있다. 이런 문제를 객체를 수정해주는 것만으로 해결 가능
각 SQL 모델을 사투리처럼 고려해놓아서 JPA를 거치면 동일하게 알아듣게 된다
Hybernate
spring framework가 채택한 JPA, 스프링에서 JPA와 통신하는 표준적인 방식
spring jpa는 hybernate를 한번 더 추상화 한 것이다. hybernate까지는 /resources/META-INF에다가 persistence.xml 파일 하나까지는 필요하다.
웹 구현할 때 패키징을 거치게 되는데 jar, war 양식으로 하게 된다.jar로 압축되어 있는데 클래스 파일들이 하나의 디렉터리로 압축된다. resources 밑에는 민감한 파일이 있어서 압축이 되지 않는데 META-INF 파일에는 중요한 파일이 저장되고 압축이 되지 않는다.
스프링에서는 이 presistence.xml 파일을 대신 만들어주고 .xml 문서가 아닌 다른 타입의 문서를 제공한다.
<persistence xmlns="http://java.sun.com/xml/ns/persistence"
             xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
             xsi:schemaLocation="http://java.sun.com/xml/ns/persistence http://java.sun.com/xml/ns/persistence/persistence_2_0.xsd"
             version="2.0">

<!--
    JAVA SE => JAVA Standard Enviroment
-->

<!--    name = id-->
    <persistence-unit name="hibernate-exp-1hibernate-exp-1">
        <properties>
            <property name ="jakarta.persistence.jdbc.url" value ="jdbc:h2:mem:test-db"/>
            <property name = "jakarta.persistence.jdbc.user" value ="sa"/>
            <property name = "jakarta.persistence.jdbc.password" value=""/>

            <property name="jakarta.persistence.schema-generation.database.action" value="create"/>
            <property name ="hibernate.show_sql" value="true"/>
            <property name ="hibernate.format_sql" value="true"/>
            <property name="hibernate.highlight_sql" value="true"/>

        </properties>
    </persistence-unit>
</persistence>
위는 사용하게 되는 hybernate의 persistence.xml 파일이다.
persistence context
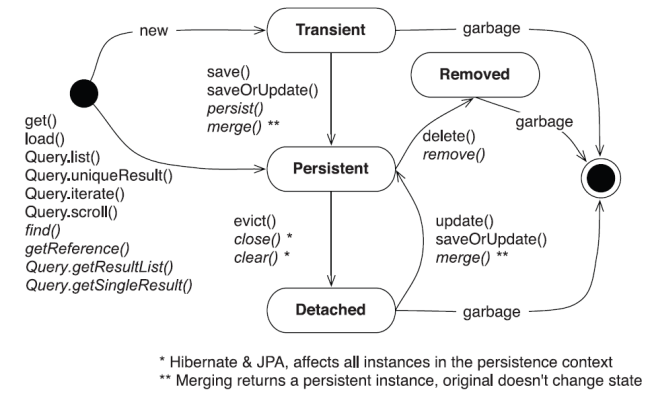
엔티티를 메모리에서 추적하고 관리하는 작업공간이다. persistence context 흔히 영속성 콘텍스트라고 부르기도 한다. 이는 mybatis의 enviroments라고 봐도 무방하고 persistence.xml파일에서 persistence-unit부분의 집합이라고 봐도 된다. 엔티티의 생명주기를 관리하고 변경 감지, 쓰기 지연, 동일성 보장까지 담당하는 핵심구조이다.
Persistence context 내의 생명주기
- transient(new)
- 비영속 상태
- entity와 관련없이 그냥 떠있는 상태
- 비영속 상태
- managed
- transient 상태가 persistence context에 의해 관리를 받게 된 상태
- detached
- 준 영속상태
- 영속성 context에 한번 들어갔다 나간 것을 의미
- persistence context가 한번 들어와서 알지만 관리를 하지 않는 상태
- 준 영속상태
- removed
- 삭제를 하면 데이터베이스에서 삭제된다.
- 데이터베이스랑 인스턴스는 다른 상태이다
- 영속성 Context에서 남아있는 것이 DB에 남아있는 상태이다.
- 영속성 context에 떠있는 이상 계속 반영된다
- 삭제를 하면 데이터베이스에서 삭제된다.
1차 캐시 first level cache
만약 같은 EntityManager/session 안에서 같은 PK를 가지는 엔티티를 두번 조회하면 두번째에는
DB보다는 persistence context에 있는 managed 상태의 객체를 재사용한다. 여기서 중요한 것은 동동성이 아닌 동일성을 보장하는 것으로 같은 영속성 컨테스트 안이라면 row를 여러개 만들지 않고 하나만 관리를 해도된다.
Drity Checking 변경감지
transient상태에서 managed로 들어올 때 스냅샷을 찍는데 그 시점에서의 entity의 상태를 순결상태라고 한다. 그리고 변화가 된 시점을 오염물이 묻은 시점이라고 하고 그것을 감지하는 것을 Dirty checking이라고 한다.
managed에 올라간 entity는 개발자가 update()와 같은 메서드를 직접 호출하지 않아도 필드가 바뀌면 Hibernate가 flush 시점에 변경 내용을 감지해서 적절한 SQL을 생성한다.
tx.begin();

Member member = em.find(Member.class, 1L);
member.setBalance(10000);   // 객체만 수정

tx.commit(); // flush 발생 -> update SQL
DB를 직접 수정을 하는 것이 아닌 영속 객체의 상태를 바꾸고 이것을 Hibernate가 DB에 반영한다.
transactional write behind, 트랜잭션 쓰기 지연
SQL을 즉시 DB에 보내지 않고 잠깐 모아두었다가 적절한 시점에 한꺼번에 반영하는 방식이다.
즉, 개발자가 엔티티를 저장하거나 수정했다고 해서 그 순간 바로 Insert, Update, Delete SQL이 즉시 시행되는 것이 아니고 변경을 persistence context와 action queue에 반영해두고 나중에 flush 시점에 SQL을 DB에 보내게 된다.
이렇게 설정한 이유는 이러한 쓰기 지연을 통해 성급하게 DB에 반영하지 않고 트랜잭션의 전체흐름을 보고 정리하여 반영하는 것이 가능하다. 그리고 쓰기 지연을 사용하면 SQL 실행시점을 모을 수 있어서 효율적이다. 그리고 batch insert/update와 같은 최적화와 궁합이 좋다.
Annotation
자바에 있는 문법, 아무 뜻이 없지만 metadata가 들어가게 된다.
yaml 파일 작성 방법
설정 파일로 정말 많이 활용하는 양식 JSON과 문법양식이 비슷해 치환되기도 한다.
key - value 기반의 계층형 데이터 표현 방식을 가지고 계층을 들여쓰기로 표현하기도 한다.
-
리스트 표현
servers: - app1 - app2 - app3 -
객체 리스트
users: - name: kim age: 20 - name: lee age: 30 -
multi - line 문자열
  text: |
  hello
  world
이런 문자열인 경우 hello world로 출력된다.
주의사항
- YAML에서는 tab키를 쓰지 말 것
yaml은 space키만을 허용한다 - name: “hello” 와 name : hello는 동일한 문자열로 취급된다
- 문자열과 구분하기 위해서 따옴표 사용해야 한다.
value : “yes” ->yes는 boolean으로 해석될 수가 있다.