 동현의 나불나불

WEB
www(world wide web)을 의미하는 말로 인터넷을 기반으로 하는 하이퍼텍스트 집합을 의미
우리가 생각하는 랜선과 같은 통신망은 이더넷(Ethernet)을 의미한다.
www와 하이퍼텍스트
하이퍼텍스트의 하이퍼란?
어떤 단어의 접두사로 사용되었을 때 초월한이라는 의미를 가진다. 하이퍼 텍스트란 단순한 페이지를 초월한 형태의 텍스트라는 것을 의미한다. 하이퍼 링크를 통해 페이지와 페이지를 연결하는 것 이러면 페이지를 넘겨서 문서를 읽는 것이 아닌 연결된 것처럼 페이지를 연결할 수가 있다.
웹에서 공유된 문서는 html로 작성해서 넘겨진다. 팀 버니스리라는 컴퓨터 과학자가 url, html, web까지 같이 무료로 풀어버렸다.
html : 웹에서 사용되는 텍스트를 표기하기 위해 사용하는 언어
웹의 핵심은 인터넷이라 불리는 물건 위에서 작동하는 하이퍼텍스트 시스템이다. 이와 비슷하게 MES에서는 웹이랑 비슷 AP라는 것을 API 대신에 사용하게 되고 소켓으로 통신을 하게된다.
웹이 돌아가는 방식
만약 우리가 식당에 입장한다고 하면 우리는 클라이언트가 되고 우리에게 서빙을 해주는 사람은 서버가 된다.
웹도 이와 마찬가지로 정보를 받는 주체는 클라이언트가 된다. 정보를 주는 주체가 되면 서버가 되고 정보를 받는 주체가 되면 클라이언트가 된다. 이는 비동기 통신을 할 때 헷갈릴 수가 있다. RES template, ajax를 다룰 때 다시 생각해야 한다.
웹은 정보공유를 위한 시스템이라고 정해놓았고 웹서버에서 정보를 열람하는 주체는 클라이언트라고 볼 수가있다. 이 정보를 열람하는 sw를 브라우저라고 한다.
웹이라는 곳에서 서버역할을 수행하는 것들 중 대표적인 2가지가 Apache Httpd, Nginx인데 이 두개는 프로세스/스레드기반, 이벤트 기반인 점이 차이가 난다. 이 두개가 웹서버 sw로 애용되고 있다. nginx는 동시처리 강하고 정적파일에 대해 매우 빠른 성능을 가지고 있다. 이들의 경우 80번과 443번 포트를 사용하게 된다.
웹서버는 이미 작성되어 있는 문서 형태(정적인 형태)를 서빙하는 형태로 동작하게 된다. 위 두 포트번호를 위 웹엔진 2개가 사용을 하게 되고 잘 알려져서 이용을 잘 안한다.
Q.정적인 컨텐츠만 서빙하면 무슨 문제가 일어날 수 있을까?
우선 네이버와 같은 대부분의 서비스는 클라이언트 요청에 따라 동적으로 제공하고 있다.
이렇게 동작하는 시스템을 웹 애플리케이션이라고 한다. 웹 동적 컨텐츠라고도 한다. 이전의 웹서버는 우리가 사용하기에는 다소 문제가 있다. 이렇게 출시한 것들이 Tomcat, Jetty와 같은 웹 애플리케이션 서버(WAS)이다.웹 애플리케이션은 웹서버 말고 WAS 위에서 돌아가게 된다. 하나의 포트에는 하나의 소프트웨어가 실행된다. 다만 하나의 소프트웨어가 여러 개의 포트번호를 가질 수가있다. 톰캣과 같은 경우 8080번 사용 파이썬과 같은 경우 8000번을 사용 view와 같은 경우 3000번을 사용한다. WAS는 다른 포트를 사용하고 이들을 다른 포트로 받아들이고 전송하는 기능을 수행하는 것 가능하다.
프론트 웹 애플리케이션
react, vue, angular 요즘은 이들을 잘 사용을 안한다. 올해 겨울부터 react는 잘 사용이 안된다.
이제는 next js가 많이 사용된다. js에는 nest.js express가 있다.
백엔드 웹 애플리케이션
django Flask FastAPI → 파이썬 기반의 백엔드 프레임워크
spring -> java
java에서는 이제 스프링밖에 쓰이지 않는데 다른 프레임워크들은 스프링이 다 잡아 먹은것이라고 볼 수가 있다.
spring의 장점으로는 백엔드 상황에서 주어진 모든 상황을 대응하는 것이 가능하다.
그전에는 jsp을 많이 사용했지만 지금은 thymeleaf로 대체했다고 한다.우리나라뿐만 아니라 다른 여러 회사들도 Spring을 사용한다.
네트워크
우리는 알게 모르게 네트워크라는 것을 사용하고 있다.
네트워크는 주변 장치들을 연결해서 사용하거나 서로 데이터를 공유해서 사용하는 것도 네트워크 연결이라고 볼 수가 있다.
LAN(Local Area Network)
여러 컴퓨터가 연결되어서 통신을 할 때 통신 범위에 따라 근거리와 같은 방이나 특정지역에서 통신하는 것을 LAN이라고 한다.
근거리나 주변 장치를 연결할 때 사용하고 컴퓨터와 준하는 장치와 연결하는 것도 LAN으로 포함된다. LAN은 하나의 지역이라고 생각해도 무방하다. 하나의 허브에 여러 대의 컴퓨터와 연결하는 방식이 있고 이를 STAR형, 성형이라고도 한다.
- 구현 방식
- 버스
하나의 공통케이블(백본)에 모든 장비 연결 - Ring
장비를 원형으로 연결, 한방향으로 데이터 순환 - Star
중앙 장비에 모든 장비를 연결, 가장 많이 사용되는 구조
- 버스
WAN(Wide Area Network)
LAN에서 얻은 정보를 기반으로 서로 다른 LAN을 연결시켜 주는 광역 네트워크이다.
대역폭(Brand Width)도 규약을 통해 . 규약이라는 것은 서로 지키도록 협약한 규칙이다. 어떠한 곳에서의 관리를 위해 정해놓은 규칙이다.
컴퓨터와 컴퓨터 사이에 데이터를 주고받는 규약을 프로토콜이라고 한다.
OSI 7계층과 TCP/IP
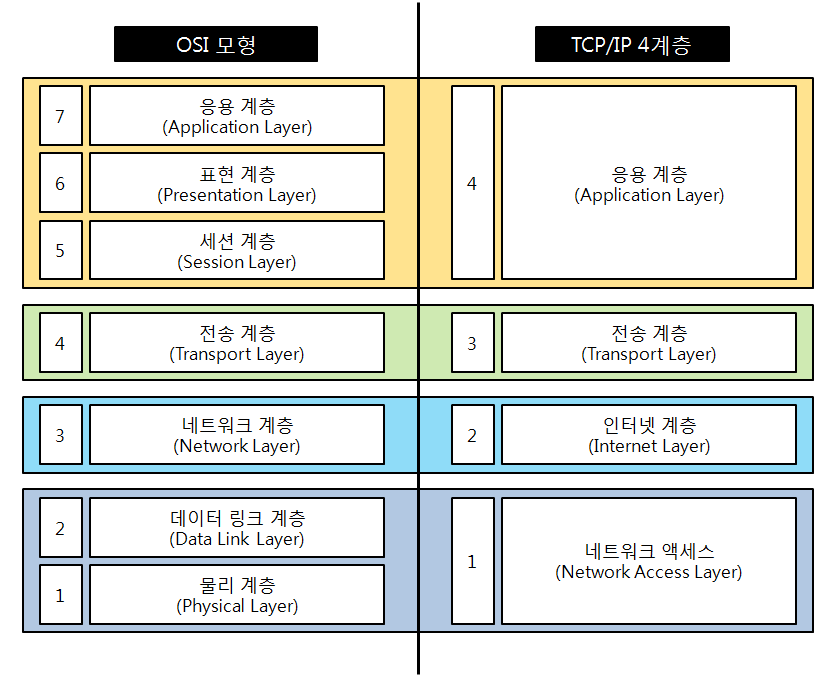
OSI 7계층은 이론적인 네트워크이고 TCP/IP는 이를 기반으로 만들어지고 실제로 사용하는 프로토콜이다.
이렇게 새롭게 탄생된 물건이 여러 보급에 의해 보급된다고 하면 호환성 문제가 생기게 된다.
처음에는 규격이라는 것이 존재하지 않아서 서로간의 데이터 교환에 문제가 생기게 된다.
문제가 컴퓨터뿐만 아니라 네트워크를 위한 장비에서도 문제가 생기게 되었다.
LAN을 컴퓨터 사이에 끼운다고 해도 통신이 되지는 않는다. 이를 중개해줄 중간장치가 필요한데 중간장치의 규격이 달라서 잘 되지 않았다고 한다. 이를 규정해주는 단체도 등장했는데 여기에는 ISO가 있다.
ISO라는 표준화를 결정하는 기구가 있는데 네트워크에서 표준화의 부재를 해결하기 위해 표준 규격을 만들었다. 이것이 OSI Model이다. 그래서 이것을 OSI 7Layer라고 부른다. OSI(Open System Interconnections)의 약자이다.
대부분의 제조사들이 이를 표준으로 해서 이용해서 모든 제조사들이 통신을 최소한으로 보장할 수 있게 되었다. 다만 OSI 7계층은 이론적인 면이 강해서 실무에서 사용하기 힘들었는데 이를 실무에 맞게 변형한 것이 TCP/IP 이다.
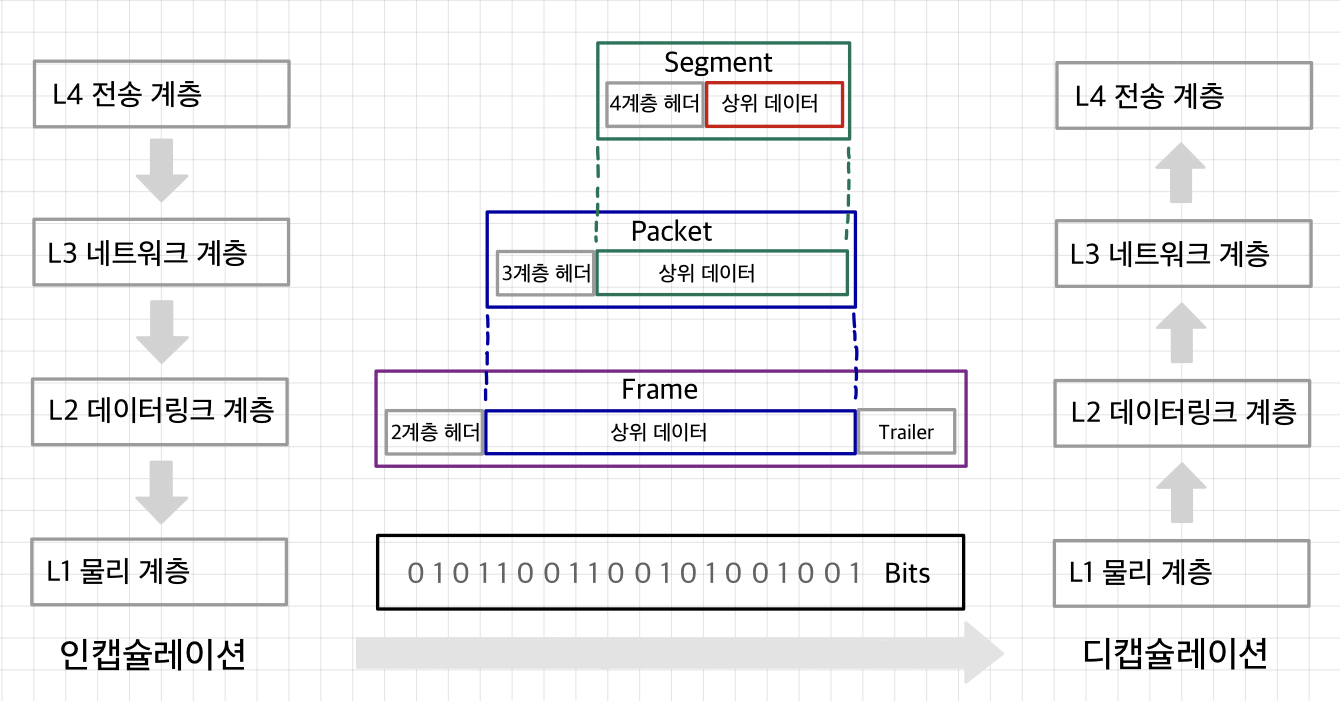
데이터의 전송과정에서 데이터를 보낼때 7 → 1으로 내려가고 수신자는 1→ 7로 올라가게 된다.
어떤 곳에 문제가 생겼는데 고치면 주먹구구식 방식인데 이렇게 계층을 나누어 놓으면 어떤 문제가 생겼는지 알기 쉬워진다.특정 계층을 변경해도 다른 계층에 영향을 크게 주지 않는다
이로 인해 네트워크 계층에 모듈화된 개발이 가능하게 되었다.
물리 계층
전기신호가 있는데 전기가 일정한 패턴으로 나오는 것 아날로그 신호랑 디지털 신호로 구분이 된다. 이 중 디지털 신호의 0,1을 비트라는 개념으로 사용하고 있다.
신호가 들어옴 → 1, 신호가 나감 → 0 즉, 실제 우리 눈에는 페이지가 보이는데 0과 1로 구분되는 페이지로 보이게 된다.
컴퓨터로 데이터를 송수신 할 때 컴퓨터 어디서 변환이 되는 것일까?
LAN 카드 → 전기신호로 받아드리고 컴퓨터가 보내는 것을 전기신호로 변환할 수 있도록 한다.
이 랜 포트에 무언가를 연결해야 통신이 된다.
전기신호를 주고받는 매개체, 케이블은 컴퓨터, 라우터 간의 신호를 전달하는 매게체가 된다.
구리선, 광섬유가 전기신호가 오가는 길이 된다. UTP 케이블을 잘라보면 선 안이 많이 비어있고 구리선이 배배 꼬아놓아져 있는데 이는 다른 전기신호의 간섭을 낮추기 위해 설계한 것이다.
Hub
전기신호는 잘가다가 어느순간 약해지는 데 우리는 어떻게 통신이 이루어지고 있을까?
아날로그 신호를 디지털 신호로 바꾸어주는 행위 → 정형이라고 한다.
허브는 들어온 전기신호를 정확히 똑같이 분배를 해준다. 입력된 하나의 신호를 복제해서 분배하거나 네트워트를 확장할 수 있는 장치이다. 신호가 약해지면 증폭해서 전달해야 하는 역할 수행한다.
데이터링크 계층
물리적으로 연결된 장치 간 ‘신뢰성 있는 데이터 전달’을 담당하는 계층이다.
이때 사용되는 주소가 MAC주소이다. 데이터를 수신받는 장치가 수신과 동시에 송신을 하게 되면 두개 이상의 장치가 송신을 하게 된다면 신호가 충돌 할 수가 있다.
데이터 링크 계층에서는 이러한 오류를 찾고 수정을 해준다. 데이터의 원활한 흐름을 위해 관리를 해준다.
이 데이터링크 계층을 실제로 구현한 표준 기술이 이더넷이다.
이더넷은 LAN에서 데이터를 보내는 실제 규칙이라고 보면 된다. 프레임구조, MAC주소 사용방식, 데이터 전송방식 등 다양한 것을 정의한다.
다수의 컴퓨터, 허브, 스위치를 하나의 네트워크 계층에 보관한다, 네트워크 계층에서 이 이더넷을 사용하고 있다라고 보면 된다. 이더넷은 일반적인 인터넷 방식에서 사용하는 기술 중 하나이다. 만약 장치 A, 장치 B. C,D가 각자의 신호를 보내고 있다고 하면 모든 컴퓨터가 충돌을 발생할 수가 있다. 이더넷에서는 이러한 충돌을 방지하기 위해 프로토콜을 하나 두고 있다.
충돌을 피하기 위해 만들어놓은 프로토콜을 CSMA /CD (Carrier Sense Multiple Access Collision Detection)이 존재한다. 이는 신호 확인 -> 공유 사용 -> 충돌 감지와 같은 3가지 과정을 거쳐 구현된다. 예전에 버스형 이더넷에서 많이 사용되었지만 현재는 스위치 기반의 스타형 구조로 이더넷을 구성하고 있어 많이 사용되지는 않는 것 같다.
2계층의 대표적인 장치으로는 switch가 존재한다.
허브랑 비슷하게 생겼고 어떤 컴퓨터와 연결되면 스위치를 통해 내보내게 된다. 여기서 네트워크를 분배해준다.
스위치는 소규모 네트워크 안에서 서로 연결해서 데이터 공유를 쉽게하는 장치이다. 다만 스위치랑 허브가 결정적인 다른 하나는 입력된 데이터를 일관되게 전송하는 것이 아닌 목적지 하나에만 전달을 한다.는 것이다. 이를 통해 넣어놓은 송신자와 수신자 정보가 있으니 mac주소를 알수있는 hash태그를 통해 거기에만 데이터를 쏴줄수가 있다.
MAC주소에 따른 전송이 가능하다는 것은 MAC주소 필터링이 가능하다는 것을 의미한다.
MAC주소
IP주소와 동시에 가질 수가 있다. MAC주소는 각각 LAN카드마다 가지는 고유한 번호 전세계에 하나만 존재한다.
MAC주소는 총 48bit로 표현을 하게된다.
- Organization Unique Idenfier → 만든 회사를 표시
- Universally Administered Address → 각 요소를 구분해주는 것
IP주소로 접근을 하고자 하고 MAC주소를 모르는 경우 내가 가고싶은 곳의 목적지를 알아야 하니 상대의 MAC주소가 무엇인지 물어보는 과정이자 MAC주소 알려달라고 모든 컴퓨터에게 요청하는 과정을 브로드 캐스트라 한다. 그리고 이 IP주소로 MAC주소를 알아낸 과정을 ARP라고 한다.
그리고 얻은 MAC주소를 이더넷 프레임안에 넣는다. 이더넷 프레임안에 MAC주소가 들어가기 때문에 ARP로 알아낸 MAC주소를 이더넷 헤더에 넣어 전송을 하게 된다. IP로 MAC주소 연결 LAN 환경을 알 수가 있다. WAN 환경은 라우터의 MAC주소를 봐야지 알 수가 있다.
네트워크 계층
서로 다른 네트워크 간에 데이터를 전달하고, 경로를 결정하는 계층이다.
-
IPv4
끝자리 255로 끝나면 IPv4
32비트로 표현 -
IPv6
ip주소가 고갈난 것에 대비해서 ip주소를 관리하는 것이 필요 A클래스, B클래스 필요하다.
IPv4와 다른 방식으로 표현한다.
128bit , 16진수와 같은 값을 포함
라우터
데이터가 어느 경로로 전달하는지 안내할 수 있는 기기이다. 원하는 목적지에 맞는 주소로 최단거리로 안내하는 역할 수행한다. 스위치가 MAC주소 기반으로 동작한다면 라우터는 IP주소를 기반으로 수행한다. 그리고 라우터에는 라우팅과 스위칭이라는 개념이 존재하는데 라우팅 알고리즘으로 최단 거리를 찾아 스위칭을 수행한다.
- 라우팅: 길을 찾는 것, 최단거리로 진행
- 스위칭 : 들어온 데이터를 적절한 경로로 빠르게 전달하는 것을 의미한다.
그리고 통신하기 위해서는 다른 라우터를 식별할 줄 알아야한다.
IP가 뭘까?
인터넷 프로토콜의 약자, 인터넷 세상에서의 장비 식별을 위한 주체를 의미한다.
라우터를 위한 IP주소는 누가 줄까? → 인터넷 서비스 제공자(Internet Service Provider, ISP)라는 주체가 준다.
ISP가 제공하는 망에 연결하여 인터넷을 사용하게 된다. ISP가 제공하는 IP을 공인 IP이라 하고 이 IP를 분해해서 다시 사용하기 때문이다. 사용목적에 따라 구분이 가능한 공인 IP와 사설 IP가 존재한다. 이 주소를 이용해서 전세계의 컴퓨터와 통신을 하게된다. 그리고 주기적으로 바뀌는 공인 IP를 유동 IP라고도 한다.
사설 IP는 내부 IP를 사용하고 인터넷에서 직접 접근이 불가하다. LAN에서 사용하는 IP주소라고 볼 수가 있다.
이러한 사설 IP주소를 쓰는 이유는 IP부족을 어느정도 해결함과 동시에 보안을 위해 사용한다. 외부에서는 하나의 공인IP만 보이게 된다.
10.0.0.0 ~ 10.255.255.255
172.16.0.0 ~ 172.31.255.255
192.168.0.0 ~ 192.168.255.255
→ 내부 IP의 예시들이다. 만들 때 제외하고 사용할 수 있도록 하는 것이 좋다.
IPv4방식을 차용했고, 4개의 10진수 숫자가 컬럼으로 분배되어 있는 경우를 의미한다.
192.168.15.2 이론적으로 사용할 수 있는 IP의 범위는 0~255가 된다.
마지막에 해당하는 비트는 0이나 255는 절대 사용할 수가 없다. 0이랑 255는 예약되어 있어서 사용할 수가 없다.
전송 계층
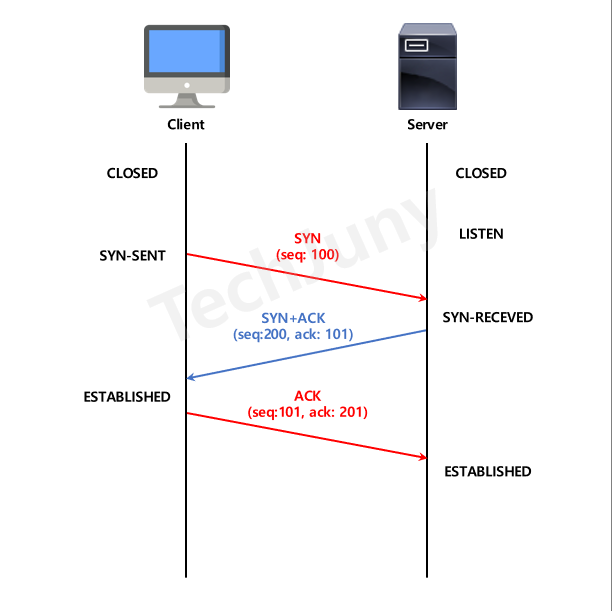
tcp 3way handshaking은 데이터를 정확하게 전달하는 것을 목표로 하고 있다. 먼저 상대가 수신가능한 상태인지 확인하고 그 확인이 되면 보내게 된다. ACK는 임의의 숫자를 더해서 보낸다. 다시 송신자 측에서 그 ACK값을 뺀 상태로 SYN을 보내게 된다. 이 과정이 되면 양쪽 모두 데이터를 통신할 준비가 되었다는 것을 의미하고 통신을 시작하게 된다.
포트
프로그램에는 포트번호란 것이 있는데 하나의 컴퓨터안에서 어떤 프로그램에게 데이터를 전달하는 기능을 수행한다.
하나의 프로그램은 여러 포트번호를 가지고 있지만 여러 프로그램은 하나의 포트번호를 가지는 것은 불가능
- 0~1023까지는 거의 다 예약이 되어있는 포트번호
- 1024~49151까지는 사전등록 포트. 어떤 프로그램을 쓸 수있어라고 되어있는 포트
- 49152~65535는 자유롭게 사용가능한 포트
잘 알려진 포트
- ssh 22번
- 네트워크를 통해 다른 컴퓨터에 안전하게 접속하기 위해 사용하는 포트
- 22번이 너무 잘알려져 있어서 요즘은 다른 포트로 지정해준다고 한다.
- 그대신 암호화가 된 SFTP(secure FTP)를 22번으로 사용하는데 파일 보낼때는 주로 이 22번을 사용하게 된다.
- SMTP 25번 : secure이 붙어서 이 포트로 메일을 보내게 된다.
- http 80번 : 패킷 감청이 되어서 잘 쓰지는 않는다, 그렇지만 보편적으로 알려진 포트번호
- https 443번 : 패킷 감청이 불가능, ssl. ttl 인증서로 보안을 해서 전달한다
http
웹에서 데이터를 주고받기 위한 약속
무상태
http 는 통신을 기억하지 않고 상태를 기억하지 않는다.
서버는 이전 요청에 대해 기억하지 않고 매번 새로운 요청으로 처리하게 된다.
비연결성
한번 3way handshake를 하고 나면 종료를 하게 되는데 이후에는 다시 3way handshake를 하게 된다. 병목현상을 줄이고 자원낭비를 줄이기 위해서 사용한다.
하지만 지속적인 연결을 해야할 때는 불편할 수가 있다.
세션과 쿠키
Http은 Stateless한 특성을 가지고 있지만 오랜 연결이나 자주 시도하는 연결에서 서버는 클라이언트가 누구인지 계속 확인을 해야한다. 이 경우 서비스를 안정적이고 빠르게 제공하기 위해 사용을 한다.
- 쿠키
- 브라우저에 저장되는 작은 데이터
- 클라이언트의 상태 정보를 로컬에 저장했다가 참조
- 하나의 쿠키값은 약 4KB까지 저장이 가능하다
- http의 reponse-header에 set-cookie 속성을 사용해 클라이언트에 쿠키를 만든다
- 브라우저 종료해도 만료시점까지 유지
- 세션보다 작은 정보를 포함한다.
-
보안은 상대적으로 약하지만 서버에 부담은 적다.
- 동작 방식
- 클라이언트가 페이지를 요청
- 서버에서 쿠키를 생성
- HTTP 헤더에 쿠키를 포함 시켜 응답
- 브라우저가 종료되어도 쿠키 만료 기간이 있다면 클라이언트에서 보관하고 있음
- 같은 요청을 할 경우 HTTP 헤더에 쿠키를 함께 보냄
- 서버에서 쿠키를 읽어 이전 상태 정보를 변경 할 필요가 있을 때 쿠키를 업데이트 하여 변경된 쿠키를 HTTP 헤더에 포함시켜 응답
- 브라우저에 저장되는 작은 데이터
- 세션
- 서버가 사용자 정보를 저장하는 방식, 서버에서 저장을 한다.
- 브라우저가 종료되면 삭제된다.
- 서버가 허용하는 한 제한이 없다.
- 세션 ID로 서버가 클라이언트를 구분하고 이에 맞는 서비스 제공
-
쿠키에 비해 보안은 강하지만 속도는 느리다.
- 동작방식
- 클라이언트가 서버에 접속시 세션ID를 받음
- 클라이언트는 세션 ID에 대해 쿠키를 사용해서 저장하고 가지고 있음
- 클라이언트는 서버에 요청할 때, 쿠키에서 받은 세션 ID를 같이 서버에 전달해서 요청
- 서버는 세션 ID를 전달 받아서 별다른 작업없이 세션 ID로 세션에 있는 클라이언트 정보를 가져와서 사용
- 클라이언트 정보를 가지고 서버 요청을 처리하여 클라이언트에게 응답
http Request
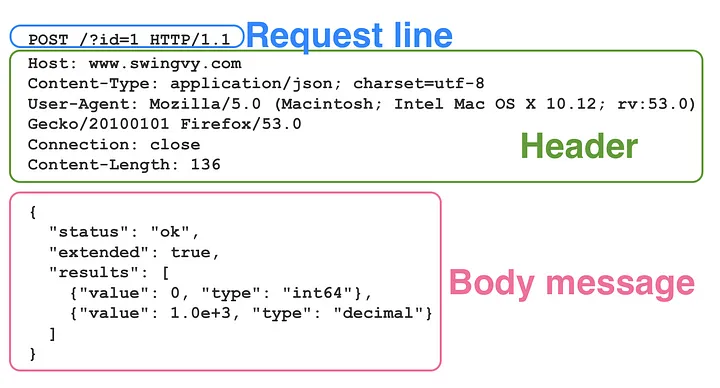
HTTP는 Request를 전송하고, Response를 전송받는 형태이며,
HTTP Request Message는 Start Line, Headers, Message Body로 이루어져있다.
- content-type: 요청 본문에 올라가는 형식이 뭔지 설명
- header은 요청을 보낼때 추가적으로 정보를 제공하는 영역, 메타데이터가 포함된다.
- User-agent : 내가 어떤 것을 사용해서 보낸것인지 표기
- content_length : 본문의 길이
Header와 Body 사이에는 한 줄의 공백이 있다.
REST API
REST란?
(Representational State Transfer)의 약자로 해당 상태의 상태를 주고받는 모든 것을 의미한다. HTTP URI(Uniform Resource Identifier)를 통해 자원(Resource)을 명시하고, HTTP Method(POST, GET, PUT, DELETE, PATCH 등)를 통해 해당 자원(URI)에 대한 CRUD Operation을 적용하는 것을 의미한다.
- 특징
-
Server-Client(서버-클라이언트 구조)
자원이 있는 쪽이 server, 요청하는 쪽이 client
서버는 API를 제공하고 비즈니스 로직 처리 및 저장을 책임진다.
클라이언트는 사용자 인증, context, 등을 직접 관리하고 책임진다. -
Stateless(무상태)
http가 stateless를 가지니 http를 이용하는 REST도 stateless를 가진다
세션과 쿠키처럼 context에 정보를 넣지 않아 구현은 비교적 단순해진다.
서버는 각각의 요청을 별개의 것으로 인식하고 처리한다. -
Cacheable(캐시 처리 가능)
웹에서 사용하는 기존 인프라를 활용가능 즉 캐시를 활용하는 것이 가능하다.
마지막 수정된 시간을 기반으로 하는 Last-Modified Tag,리소스의 내용 자체를 기반으로 한 E-tag를 통해 캐싱을 구현한다.
이 기능을 통해 대량의 요청을 효율적으로 처리 가능하다. -
Layered System(계층화)
클라이언트는 REST API 서버만 호출하게 된다. REST API 서버는 다층 계층으로 구성될 수가 있다. 이는 보안, 로드 밸런싱등을 위해 사용한다고 볼 수가 있다.
클라이언트는 서버와 통신할 때 어느 계층의 서버인지 알 수가 없다. -
Uniform Interface(인터페이스 일관성)
API를 사용해야 하니 일관된 규칙으로 설계되어야 한다. URI로 지정한 Resource에 대한 요청을 통일하고 일관된 Method를 사용하도록 한다.
또한 서버와 클라이언트가 서로의 상태를 모르니 loosely Coupling 형태를 갖는다고도 볼 수가 있다.
-
http Method
- GET : 서버에 있는 리소스 조회
- POST: 서버에 데이터를 전송하여 요청 데이터 처리, 주로 등록에 사용
- PUT : 서버의 기존 리소스를 대체(덮어쓰기), 해당 리소스가 없으면 생성
- PATCH : 서버의 리소스 일부 변경 (PUT이 전체 변경, PATCH는 일부 변경)
- DELETE : 서버에 있는 리소스 삭제
http Response
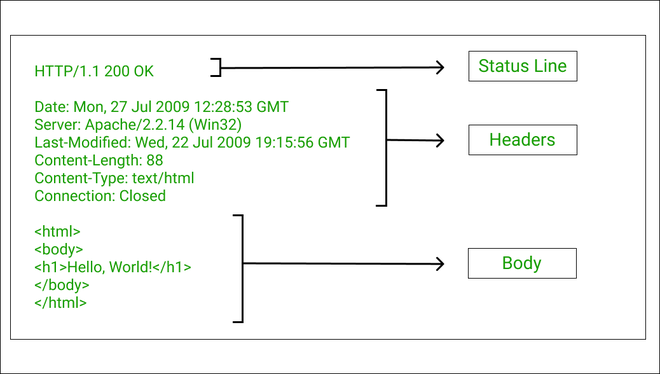
- version of HTTP은 요청과 달라도 무방하다.
다만, STATUS CODE는 무조건 정확하게 보내줘야 한다.
이 상태를 보고 어떤 것을 해야 하는지 정확한 스탠스를 취해야 할 필요가 있다.
이것을 어기면 버그가 일어나기가 쉽다. 헤더까지 읽고 나면 HTTP문서로 취급을 하게된다.
http Status Code
- 1xx : 프로토콜을 바꾸거나 그런 특수한 경우에만 보임 → 거의 보이지 않는다.
- 2xx : 제일 많이 쓰는 것, 204, 205
-
3xx : url을 바꾸어서 보낸경우
- 4xx: 네잘못, bad request (중요)
클라이언트가 없는 것을 달라한 경우, 뭐를 요청했는데 없는 것 - 5xx: 내잘못 (중요)
서버 애플리케이션이 잘못한 경우, timeout, bad gateway
요청은 문제없으나 서버 처리에 문제가 생기는 경우
500은 잘못하면 보안 취약점으로 연결될 수 있기 때문에 stack trace가 쌓이게 하는 악용할 수가 있다.
500은 그래도 무조건 안보여주는 것은 안되지만 java 잘못도 가끔 500이 뜰 수가 있다.
개발시 메세지를 적어줄 수가 있다.
DB만큼 설계하는 것이 중요하다.
내가 RESTful 하게 설계했는가?, 내가 돌려지고 있는 곳에 정확하게 설계를 했는가?
때에 따라 내가 의도한 코드와 다르게 사용할 수도 있기 때문이다.
이 때문에 서블릿을 알아야 한다. 서블릿은 인터페이스이고 서블릿이 실행되어야 하는 환경이 필요하다. 그 환경이 WAS이고 tomcat과 jetty가 그 종류다. 그 서블릿을 실행시킬 수 있기 때문에 서블릿 컨테이너라고 한다.
서블릿 컨테이너를 초기화하고 나서 스프링을 동작시킨다.
Spring 서론
MVC 패턴
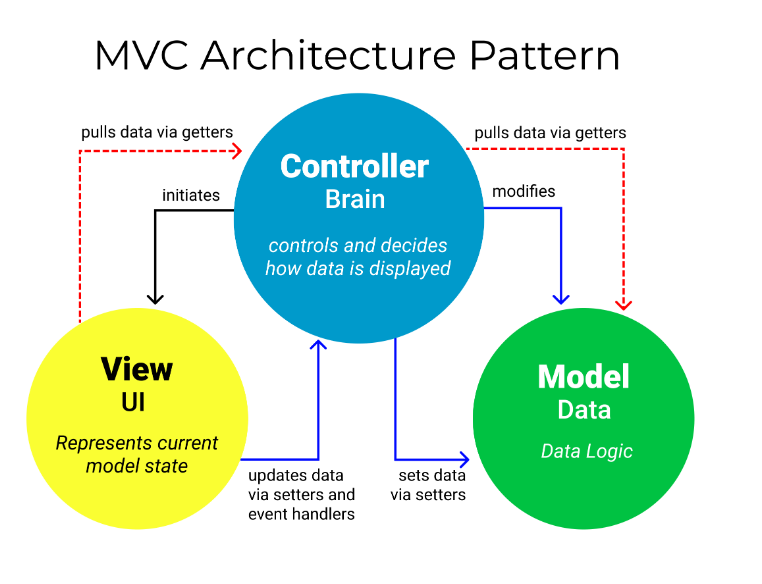
- model
- 애플리케이션의 핵심 데이터와 비지니스 로직을 담당
- repository와 상호작용, 데이터 처리 및 유효성 검사 담당
- 독립적으로 작동하고 view나 controller와 직접적으로 통신하지 않는다.
- view
- 사용자에게 보여주는 화면, 즉 UI 담당
- 사용자 입력을 처리하고 적절한 모델기능을 호출
- Controller
- 사용자의 요청에 대한 조정을 수행한다.
- 모델 함수의 결과를 받아 뷰에 전달
주의사항
- 결합도 최소화를 위해 구성 요소간의 직접적인 참조를 피해야 한다.
- 다른 구성 요소와의 의존성을 최소화해야 한다.
spring에서 model에 해당하는 annotation은 없다. controller, service, repository에 관한 어노테이션을 제공해준다.
연관되어 있는 것에 대해 서비스를 제공해준다. 필요하다면 view가 끼어들게 된다. jsp나 thymeleaf가 이 기능을 수행한다. 요청에 대한 조정을 controller에서 수행하게 된다.
만약 정답이 되면 model에서 결과를 만들고 view에서 보여주도록 한다.