 동현의 나불나불

앞으로도 많이 사용할 IntelliJ 단축키
단축키
- 세미콜론(;) 넣기 : ctrl alt enter
- 코드 이동 : alt shift 방향키
- 매서드 추출 : ctrl alt m
- 변수 추출 : ctrl alt v
- 함수 매개변수 확인 : ctrl p
- shift f6 : 변수와 이름이 같은 모든 것을 바꿀 수가 있다.
- alt shift : 여러개 클릭
- psvm : 메인함수 정의
- sout : 출력함수 출력
JDBC 활용
기본적인 JDBC쿼리
    //select문을 실행
    stmt.executeQuery("select * from mytable")
    //insert, update, delete문 실행
    stmt.executeUpdate("insert into mytable values ('string_val', 'float_val')");
// query resultSet으로 query의 실행문을 받아
// while로 next로 각 column에 맞는 값을 입력받아 진행
    ResultSet multipleResultSet = multipleResultStmt.executeQuery();

    // Iterator
    while(multipleResultSet.next()) {

        long id = multipleResultSet.getLong("id");
        String name = multipleResultSet.getString("name");
        int price = multipleResultSet.getInt("price");
        int stock = multipleResultSet.getInt("stock");

        System.out.printf("%d번 상품 %s, 가격: %d, 재고: %d\n", id, name, price, stock);

    }
Result 출력
ResultSet 객체는 데이터베이스 쿼리의 결과 집합을 나타낸다. 이때 ResultSet은 커서 방식을 사용하는데 내부에 커서를 두고 이동하게 된다. 이때 커서는 단방향으로 움직이게 된다. 이는 DB나 드라이버 내부 구현이 단순해지고 트랜잭션/커넥션 유지 부담이 감소해서 그렇다.
//ResultSet
private static int getStock(Connection conn, Long productId) throws SQLException {
    String sql = "select stock from product where id = ?";
    try(PreparedStatement stmt = conn.prepareStatement(sql)){
        stmt.setLong(1, productId);
        try(ResultSet rs = stmt.executeQuery()){
            return rs.next() ? rs.getInt("stock") : 0;
        }
    }
}
주의 SQL injection
정의 : 임의의 SQL문을 주입하고 실행되게 하여 취약점 침입을 하는 것
- SQL injection 예시
select
    *
from
    member
where
    email = 'user@email'and password = '' OR '' = '';
위와 같이 비밀번호를 TRUE로 만들어주는 값을 대입하여 사용자 정보를 탈취하는 것이 가능하다.
이에 대한 기본적인 보안으로 jdbc에서는 prepaerStatement 기능을 제공하고 있다.
prepareStatement
SQL쿼리의 구조를 미리 정의하고 사용자 입력 값을 파리미터로 처리 이 경우 DB가 값을 데이터로만 처리하고 SQL코드로는 인식을 하지 않는다.
String sql = "SELECT * FROM users WHERE id = ?";
PreparedStatement ps = conn.prepareStatement(sql);
ps.setString(1, "user1");

ResultSet rs = ps.executeQuery();
prepareStatement를 사용하게 되면 SQL구조가 먼저 DB에 도달하게 되고 DB가 쿼리 파싱, 컴파일을 거치고 ?에 값만 나중에 바인딩이 된다.
try (
    Connection conn = ds.getConnection();
    PreparedStatement ps = conn.prepareStatement(sql)
) {
    ps.setString(1, userInput);
    ResultSet rs = ps.executeQuery();
}
이런 식으로 setString() 메서드로 값을 넘긴다.
PreparedStatement preparedStatement = conn.prepareStatement(safeLoginQuery);
preparedStatement.setString(1, user1Email);
preparedStatement.setString(2, user1Pwd);

ResultSet safeResultSet1 = preparedStatement.executeQuery();
그리고 넘긴 답을 바탕으로 executeQuery() 메서드를 통해 실행을 하게된다.
커넥션 풀
배경 : JBDC 연결은 드라이버를 로드하고 연결하여 객체를 받아와야 하는 과정을 거치게 되는데 이때 되게 많은 시간과 자원소모에 대한 단점을 가지게 된다.
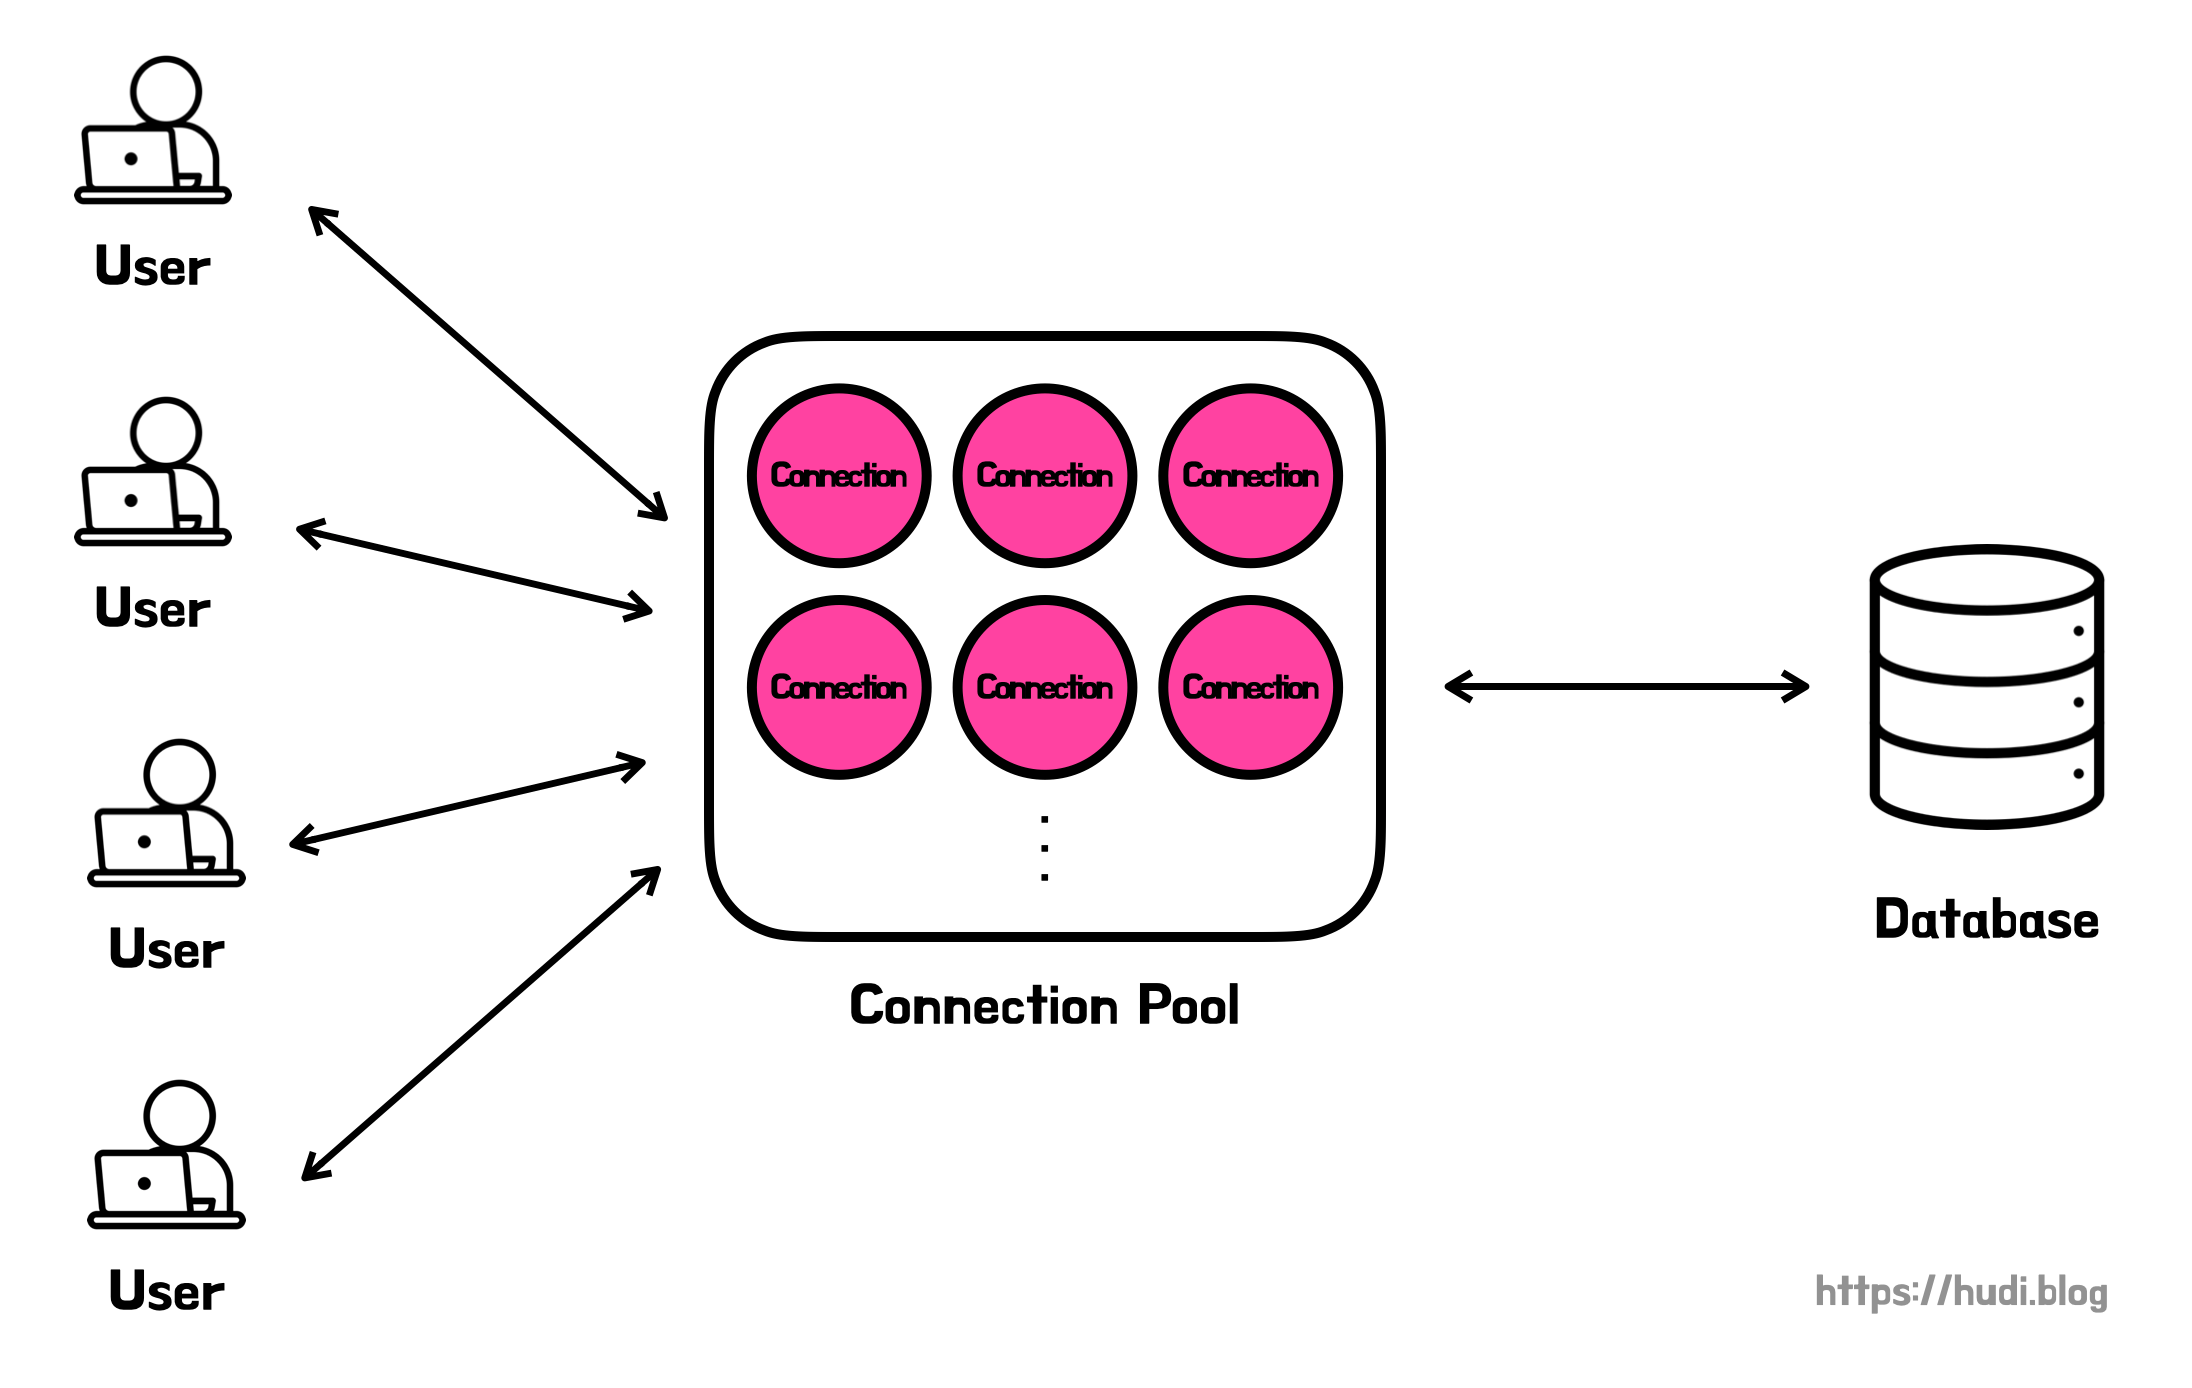
개념 : 최초 Pool 내에서 Connection들을 하여 HTTP 요청에 따라 응답을 제공하고 반환받아서 이를 재사용하는 것
과정
- 애플리케이션이 실행되면서 POOL 내에 connection들을 생성해둔다.
- HTTP의 요청이 올 때 Pool 내에서 Connection 객체를 가져다 사용
- 사용이 완료된 Connection 객체는 Pool 내에 반환된다.
DB가 동시에 처리할 수 있는 적절한 커넥션 개수
(코어 수 × 2) + 유효 디스크 스핀들 수
(SSD 환경: 코어 × 2 + 1)
hikariCP
- 고성능, 경량 JDBC 커넥션 풀을 제공하는 오픈소스라이브러리
- 커넥션 풀이 설정된 커넥션의 사이즈만큼 연결을 허용하며 HTTP 요청에 대해 순차적으로 DB 커넥션을 처리주는 기능 수행
HikariConfig config = new HikariConfig();

config.setMaximumPoolSize(10); // 최대 커넥션 수
config.setMinimumIdle(5);      // 최소 유지 커넥션
config.setConnectionTimeout(30000); // 대기 시간
팁 static 코드 블록을 사용하는 이유
static {
    HikariConfig config = new HikariConfig();

        config.setJdbcUrl(JDBC_URL);
        config.setUsername(USERNAME);
        config.setPassword(PASSWORD);
        config.setDriverClassName(DRIVER_CLASS_NAME);

        hikariDataSource = new HikariDataSource(config);
}
static 코드 블록은 자바 클래스 로딩 시 딱 한 번만 시행되는 초기화 코드로 커넥션 풀을 애플리케이션 시작 시 1번만 생성하는 것이 가능하다. 이는 싱글톤 초기화에 적합하고 HikariCP는 DB연결 생성 시 생성 비용이 존재, 내부적으로 커넥션 풀을 관리, 애플리케이션 전역에서 공유를 하기 때문에 적합하다고 볼 수가 있다.
트랜잭션에서 finally setAutoCommit(true)를 넣는 이유
try{

}catch (Exception e){
        connection.rollback();
}finally{
    connection.setAutoCommit(true);
}
이는 커넥션 풀 환경에서 필수적인 안전장치이다. 다음 사람이 같은 커넥션을 쓸 때 트랜잭션을 꼬이지 않게 하기 위해서 필요하다 만약 임의의A 사용자가 커넥션을 가져간 상태라면 autoCommit이 false로 변경된다. 작업이 끝났는데 커넥션을 반납했는데 autoCommit을 안돌렸다면 그 커넥션을 가져간 다음 사용자 B는 수동 트랜잭션 상태에서 시작하게 된다. 이 경우 사용자 B는 commit()을 안하면 데이터가 반영안되고 lock, 예상치 못한 rollback이 생길 수도 있다.
scope 공부
Scope란?
변수나 메서드, 클래스가 어디서부터 어디까지 접근 가능한지 정의하는 범위
백엔드 개발에서 멀티 스레드를 통한 여러 요청을 동시 처리, 메모리 관리 등 직무와 크게 연관있기 때문에 필수적인 역량이다. 이는 객체의 생명주기와 공유 범위를 결정하고 멀티스레드 환경에서 데이터 정합성과 성능에 직접적인 영향을 주는 요소이다.
종류
클래스 스코프
- 클래스 스코프는 클래스 전체에서 접근할 수 있는 변수나 메소드의 범위를 의미
메서드 스코프
- 메소드 내에서 선언된 변수들이 가지는 범위
- 메소드가 종료될 때 소멸된다.
- 메소드 내부에서 접근 가능하며, 메소드가 호출될 때마다 새롭게 생성
블록 스코프
- {}로 묶인 코드 블록내에서 선언된 변수들이 가지는 범위
- 변수들은 해당 블록 내에서만 유효, 블록을 벗어나면 소멸
scope 잘 모르면 터질 수 있는 문제
- static 남용
static int count = 0;모든 요쳥에 공유되고 이로 인해 여러 스레드를 동시에 수정해야 할 수도 있다.
race condition을 발생시킬 우려가 있다.
- 지역변수 vs 인스턴스 변수 혼동
public class UserService {
 private User user;

 public void save(User u) {
     this.user = u;
 }
}
만약 싱글톤 객체를 불러오는 경우 여러 요청이 같은 user을 공유할 때
데이터가 섞일 우려가 있다. 하나일 때는 별문제가 없어 보일 수도 있지만 여러 사용자가 동시에 요청하는 경우 데이터가 섞여져서 데이터 오염이 된다. 참고로 이런 멀티쓰레드 문제를 synchronized로 해결을 하려고 하면 Bottleneck이 생길 우려가 있어 권장하지 않는다.
- 메모리 누수
필요 없는 객체를 넓은 scope에 두어 사용하게 되면 요청마다 데이터가 추가되게 된다. 이 경우 java의 GC(Garbage Collector)가 수거를 못하게 되어 메모리가 계속 쌓이게 되고 서버 메모리가 증가해 서버가 느려지게 된다.