 동현의 나불나불

Elastic Search
서론
로깅으로도 사용하지만 검색으로도 많이 사용한다. DB의 like 검색기능보다 훨씬 좋은 성능을 가지고 있어서 검색엔진으로 활용되기도 한다.
만약 동의어를 찾아주는 것을 RDB로 하면 동의어를 다 DB에 넣거나 보완을 해야 하는데 이는 너무 시간이 많이든다.
로그 서치와 관련된 내용은 elasticsearch에서 만든 것은 아니다. docker와 유사하게 무언가 어떤 라이브러리로 만들어진 제품이다.
그 라이브러리는 아파치의 루씬이라는 것으로 만들어졌다. 이 루씬을 통해 elasticsearch과 유사한 프로그램을 만드는 것이 가능하다.
이 라이브러리의 기능으로 많은 데이터 사이에서 full text search를 가능하도록 한다.
이 elasticsearch는 분산적 , 수평적 구조가 가능하고 REST API를 통해 다른 것을 사용할 필요없이 쉽게 연동하는 것이 가능하다.
elasticsearch도 항상 장점만이 존재하는 것이 아니다.
elasticsearch의 단점
- 공식적 transaction 지원, join이라는 것이 없다.
- 클러스터 관리, 튜닝에 대한 러닝 커브가 존재한다.
시계열 DB로 존재를 한다. 데이터 정합성 및 관리를 위해서도 RDB를 완전히 대체는 불가능하다. 다만 검색과 분석이라는 영역에서 사용하는 보완적인 영역이라고 볼 수가 있다.
어떤 서비스를 이용할 때 그 서비스에 관한 것을 살펴볼 필요가 있다. 이제 만드는 것도 가능하기 때문에 어떤 식으로 만들어졌는지를 아는 것도 좋은 경험이 될 수가 있다.
서비스의 사용자의 경험을 결정하게 되는 핵심적인 요소이다. 검색있는 서비스를 무조건 쓰게 된다.
RDB의 %를 통한 검색과의 차이
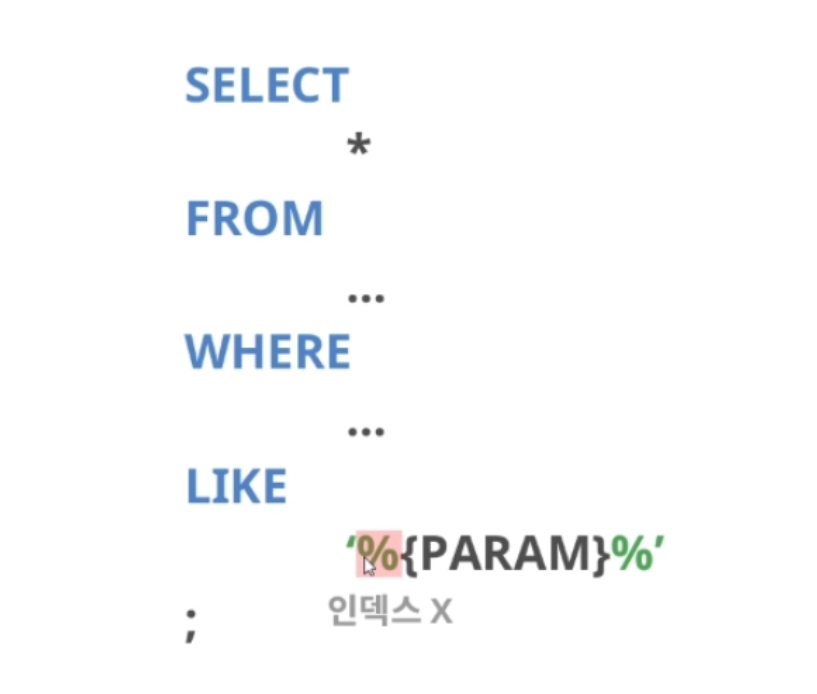
RDB는 데이터를 관리하고 데이터의 정합성을 보장한다. 구조화 된 데이터를 다루는 것에는 강점이 있다. 하지만 비정형화 데이터를 다루는데는 강점이 있다.
속도가 중요하지 않은 서비스에는 이것은 큰 문제가 되지 않는다. 앞에 %가 있다고 하면 인덱스를 안타게 된다.(%kim이라면 문자열 어디에 kim이 있는지 알지 못하므로)
데이터베이스에 있는 엔진은 순회를 하면서 스캔을 수행하게 된다. 10만 건까지는 문제가 안되지만 100만 건까지는 문제가 될 수밖에 없다.
이는 선형적으로 시간이 증가하기 때문에 대응을 할 필요가 있다.
Full text Search 전문 검색
의미를 가진 단어로 본 다음에 전문 검색을 통해 찾아내게 된다. 텍스트 데이터를 단순한 단어로 보는 것이 아니라 의미를 가진 단어로 취급하여 검색을 통해 빠르게 찾아내게 된다.
문장을 의미 있는 단위로 쪼갤 수 있어야 한다. 만약에 변형된 형태가 있다면 기본형으로 다룰 수 있어야 한다.
영어를 기준으로는 원형으로 바꾸어주는 작업을 해놓아야 한다. 그런 것을 미리 해놔야지 전문검색을 할 수가 있다.
index는 색인이고 elasticsearch는 역색인을 건다. inverted index를 걸게 된다.
관련성 점수를 계산한게 된다. 관련성 점수도 필요하다. 퍼지 매핑, n-gram 등의 있어야지 이것을 적용하기 쉽다.
검색 시나리오가 복잡하면 복잡할수록 건드릴 수가 없다.
NoSQL Database
Not Only SQL이라고 본다. NoSQL는 RDBS가 잘하지 못하는 분야를 수정하기 위해서 존재한다.
키밸류 스토어인 redis가 있고 Amazon DynamoDB가 있다. document, document store이라는 것이 있는데 document형태의 정보가 있고
document 스토어를 불러오게 된다.
검색 엔진은 문서에서 특정 작업을 하는 것인데 복잡한 분석작업에서 텍스트에서 어떤 내용이 있는지 확인을 하고 싶어한다.
엄청나게 많은 것을 노드에 보관하게 되고 빠른 검색을 필요로 하게 된다.
다중 저장소 활용(Polyclot Persistence)
상품 검색은 elasticsearch는 redis에서 elasticsearch를 통해 목적에 맞게 다양한 방식으로 사용하는 것을 polyclot persistence라고 한다.
이는 MSA에서 사용하는 패턴이다.
apache lucene을 기반으로 만들어진 engine이 elasticsearch이다.
특징으로는 대규모 데이터를 저장하고 대규모 데이터에 대해 실시간 검색을 할 수 있도록 하여 비정형 데이터, 복잡한 집계 검색까지 가능하도록 한다.
검색을 하면 아무리 많은 데이터라도 실시간으로 분석까지 할 수 있다.. 1초 이내로 검색이 가능하다.
실시간이 아니라 1초 이내의 우리가 검색될 수 있도록 만들어주는 것이다. 실시간이랑 같은 수준이다.
restAPI를 제공한다. 모든 작업에 관해 Http 작업을 수행하게 되고 curl같은 도구나 rest template와 같이 elasticsearch와 연동이 가능하다. 쉽게 여러 대의 cluster을 연결하여 용량이 부족해도 쉽게 확장이 가능하다.
장애가 발생하더라도 레플리카가 있는 노드에서 대체를 하게 된다. 이를 통해 고가용성을 보장해준다고 할 수 있다.
DB와 검색엔진은 설계목적부터 다르다.
RDB
- 데이터의 무결성 보장, 정확한 데이터 조회를 하는 것이 목적
- 강한 일관성 제공, 모든 과정에서 일관성
- 트랜잭션 제공
ELK
- 검색엔진은 빠르고 좋은 검색 결과를 제공하는 것이 목적
- 공식적으로 트랜잭션 x
- 결과만 일관성있게 제공하는 것을 목적으로 한다.
데이터 무결성 보장이 어렵기 때문에 핵심 비지니스 로직에는 RDB를 사용하는 것이 좋다.
따라서 이중 보장을 하기 위해 둘다 사용한다. 검색이 필요한 데이터만 복제하여 elasticsearch로 이동시킨다.
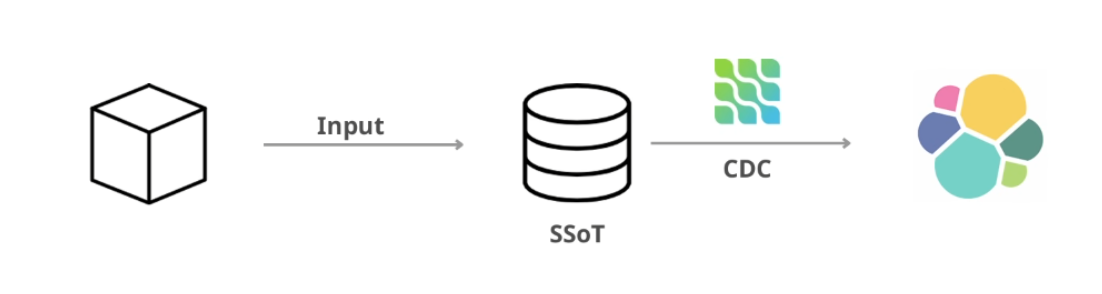
단일진실 공급원, Single Source of Truth, SSOT
혼선을 방지할 수 있고 데이터의 일관성을 유지하는데 큰 도움이 된다. 데이터 동기화가 가장 큰 문제가 되는데 elasticsearch를 어떻게 동기화를 해야할 지 큰 문제가 된다.
change data pattern 메세지 큐를 들어가거나 할 때 도움이 된다. elasticsearch를 살펴보기 위해 내부노드를 사용하는데 큰 도움이 될 수가 있다.
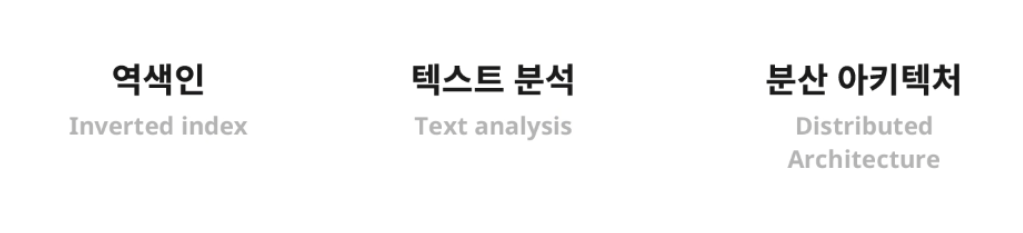
이러한 분산구조 덕분에 대규모 데이터를 다루어도 도움이 된다.
원래 하나의 데이터베이스 있었다면 인스턴스가 있는데 장애가 있는 것을 고려해서 응답률이 보장된 여러 개의 인스턴스를 두는 것이다.
정상적으로 클러스터링을 하려면
- 한 곳에 저장된 것이 다른 곳에 동일하게 저장될 수 있도록 하는 것이 좋다.
하나의 클러스터 안에는 여러 개의 구성이 있을 수가 있다. 각각의 구성원을 노드라고 부른다. 종류는 마스터 노드 , 슬레이브 노드로 나뉘게 된다.
왜 이렇게 구분을 하는가? 마스터 노드는 슬레이브 노드에게 일을 준다.
마스터 노드의 업무
- 인덱스 생성
- 샤드 배치
- 노드 추가/제거 감지
- 클러스터 상태 관리
선출권이라는 것이 있다.
선출권을 가진 슬레이브 노드끼리 경쟁을 한다. 이때 누가 더 한가로운가를 경쟁을 하게 된다. 비슷한 애들끼리 투표를 한다. 투표에 뽑힌 노드는 마스터로 선출을 하게 된다.
회복성 패턴이 적용되어 있다. 또한 자고있는 애를 깨워서 일하게 한다.
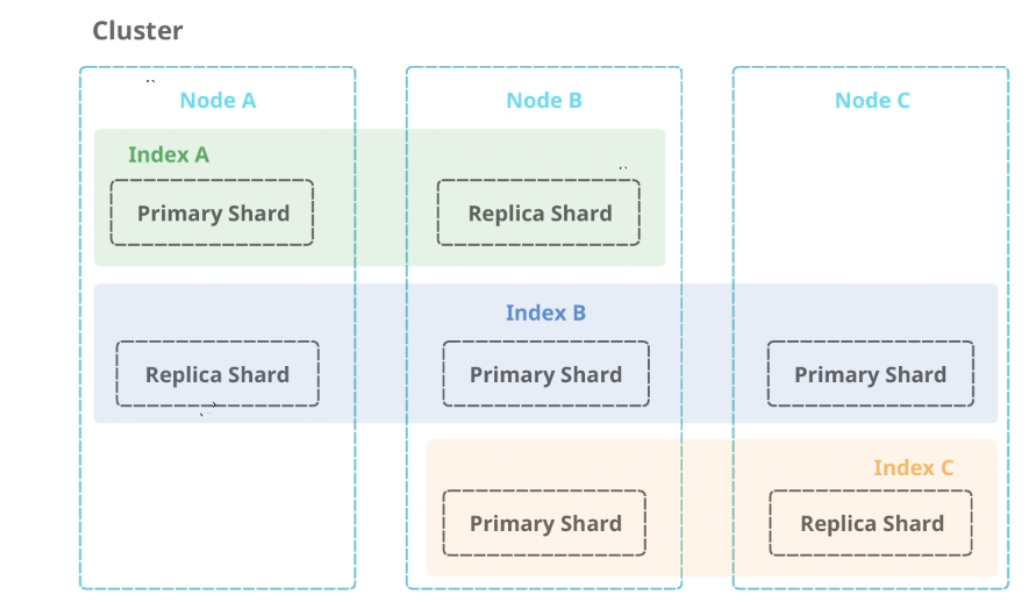
똑같은 것을 4개를 만들었기 때문에 비용이 발생한다. DB에서 이러한 것을 고려한 기능이 있다.’특정 기준을 통해 나누어 놓는 것을 샤딩(sharding)이라고 한다.
shard는 인덱스를 물리적으로 분리한 조각을 의미하고 replica는 복제본을 의미하게 된다.
데이터를 여러 서버에 복제를 해놔야 한다. 이것을 replica라고 한다. 여러 서버가 병렬로 처리를 해야한다. 이를 분산처리라고 한다.
클러스터만 구성을 하고 인덱스라는 것을 만들어두면 elasticsearch가 분산처리를 하고 장애복구까지 해주게 된다. ABC 노드가 클러스터링이 쉽고 대규모 서버에서 관리하기 좋긴하다.
역색인 Inverted Index
검색속도가 빠른 것에 대한 이유, 일반적인 index와 방향이 반대되는 구조
elasticsearch가 밀리단위로 접근할 수 있는지에 관해 나오게 된다.
중요한 용어들과 페이지들에 관해 나열을 하게 된다.
모든 문서를 하나하나 검색하는 대신 모든 문서를 쉽게 찾을 수 있도록 하는 것
색인은 “이 단어의 위치가 어디에 있어”라는 식으로 기술을 하게 된다. 하지만 역색인은 “이 위치에 이 단어가 있어“ 이런 식으로 기술을 하게 된다.
ST -001와 같은 것으로 정보를 찾는 것이 정방향 index이다.
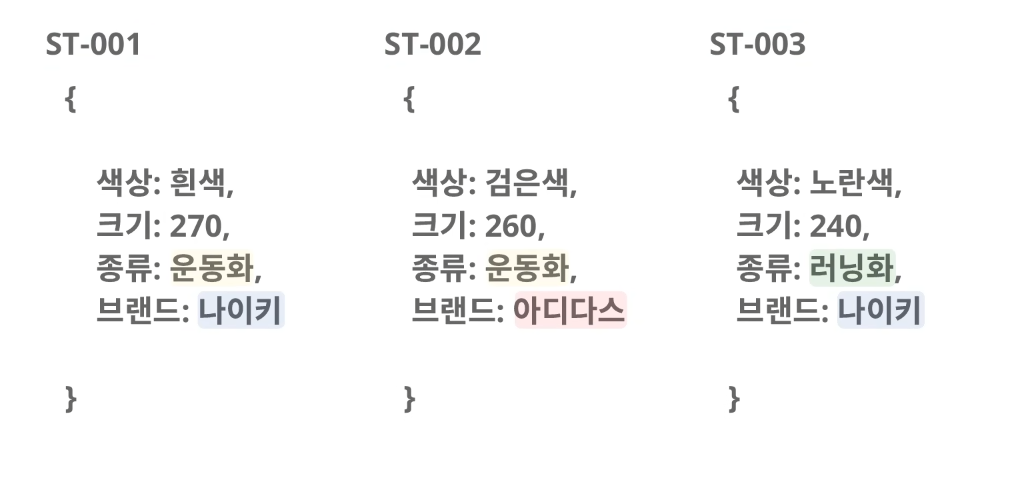
하지만 역색인은 이와 다르게 단어에다가 문서를 매핑을 하게 된다. 문서안에 들어있는 값에다가 문서를 매칭하게 된다. 역색인은 정렬되어 있다. 특정 단어를 빠르게 찾을 수가 있다. 5logn → 이런 식으로 찾는 것이 가능하다.
각각의 문서에 어떤 값이 들어있는지 찾을 수가 있다.
텍스트 분석 Text Analysis
검색을 할 수 있도록 정규화를 할 필요가 있다. 문장을 의미단위로 쪼개고 의미 단위가 무엇인지를 알 필요가 있다.
텍스트 분석이 왜 필요한가? 나이크 운동화들이라고 있다면 문자열을 비교하여 매칭, 텍스트 분석은 이 문장 자체를 역색인하는 시점, 사용자가 검색을 하는 시점 두시점에 같은 분석기를 사용해야 같은 결과가 나올 수가 있다.
같은 시점에 나이키와 운동화를 분석해야지 같은 결과가 나올 수가 있다.
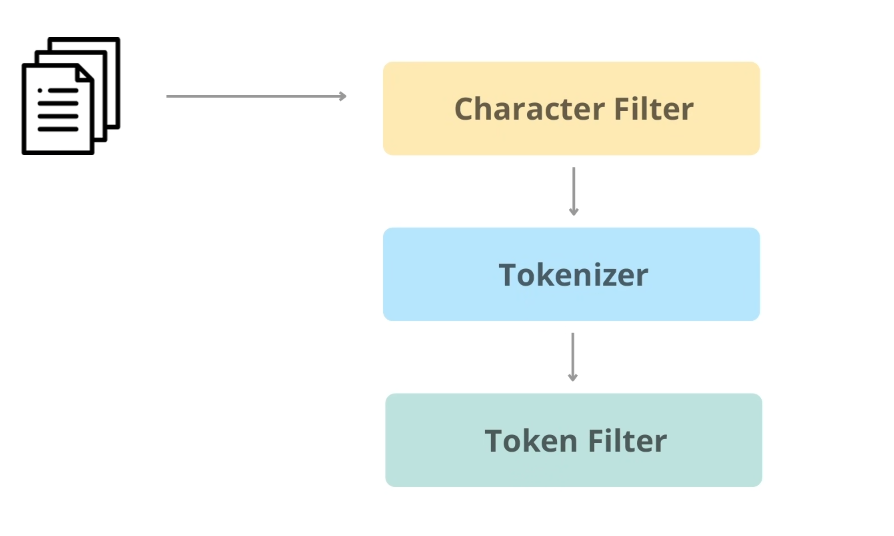
텍스트 분석을 해보야겠다. 분석기는 3단계의 과정으로 분리되어있다.
character Filter → Tokenizer → Token Filter
- Character Filter
- 원본필터를 전처리
- Tokenizer
- 텍스트를 토큰단위로 분리
- Token Filter
- 토큰 필터가 각각의 필터로 제거과정을 거치게 된다.
각각의 필터는 있을 수도 있고 없을 수도 있다. 토크나이저는 1개만 있어야 한다.
Character Filter은 분석기가 만나는 첫번째 필터를 의미한다. 특정 문자열을 패턴에 맞는 것을 분리를 해준다.
여러 개를 쓰면 파이프라인으로 출력이 된다. 만약에 indexing 해놓은 문자열이 html인 경우 필요없는 문자열이 태그 <>, 와 같은 부분은 필요가 없다.
의미 변환을 해주고 싶다고 한다면 정규 표현식에 맞게 부분적으로 치환하여 수행을 하는 것이 좋다.
들어온 문자열에 관해 전처리를 해주는 것이 Character Filter이다.
모든 분석기는 Tokenizer을 가지고 있어야 한다. 1개만 가지고 있어야 한다.
토큰화를 한다는 것은 분리해서 단어를 하나하나 갖는다는 것을 의미한다. 공백만으로는 토큰을 분리하기가 쉽지 않다.
드시다. 먹었다와 같이 같은 의미라도 단어가 다른 것이 있기 때문이다. 언어별로 토크나이저는 다른 것을 사용해줘야 한다.
한국어는 형태소 해석을 해야 하는데 이 standard Tokenizer가 분리하기가 쉽지 않다. 입력 텍스트 전체를 정규표현식으로 만들거나
n-gram tokenizer n개의 텍스트로 분리를 하는 것이다. 나이키를 사용한다고 하면 2,1개씩 토큰을 나누어 만들어지곤 한다.
이렇게 해야 자동 완성이나 부분 완성이 가능해진다. 이 n-gram으로 만들어지는 것이 가능해진다.
한글에는 nori라는 형태소 분석기가 있다. 이것이 한글 형태소 분석기이다.
Token Filter라는 것이 있다. 이 Token Filter을 순서대로 적용할 수 있으면 동일하게 동작을 하게된다.
이 토큰에 관한 필터라고 본다. LowerCase TokenFilter, UpperCase, TokenFilter 이라는 것이 존재한다.
한국어와 같은 경우에는 먹히지 않는다.
-
stopToken Filter
불용어, 관사(명사를 꾸며주는 말), 명사를 지칭해주거나 표시해주는 말을 의미한다.
불용어는 제거해줘야 한다. 너무 흔해서 도움이 되지 않는 말, 불용어를 제거하여 성능을 높이게 된다. -
synonym(동의어)
동의어를 추가하면 신발을 검색하면 러닝화, 워킹화 등을 같은 검색에도 나올 수 있게 하는 것이다. -
Stemmer 토큰 필터
과거형을 원어로 바꾸어주는 토큰 필터이다. 토큰을 많이 저장하면 오히려 역으로 나오게 된다.
Token Filter가 된다면 너무 많이 나오거나 할 때 점수가 과하게 책정되는 경우 패널티를 주거나 할 때 사용하게 된다. -
ascii code running Filter
성조가 있는 경우 색인시점과 분석과정에서 색인할 때 소문자로 나오게 되면 검색할 때도 소문자로 나오게 해야 한다.
Query DSL
elasticsearch에서 색인하기 위한 DSL (sping JPA에서 사용하는 DSL과 다르다)
요청 본문에 관한 것을 처리해줘야 한다. 라이브러리가 아닌 도메인 specific language이다.
특정한 목적을 위해 사용하는 DSL이다.
Match Query : 가장 많이 사용하는 전문 검색(Full Text Search)
{
   "query": {
      "match": {
         "title": "spring boot"
      }
   }
}
이런 식으로 match를 사용해서 단어를 기준으로 검색을 시행하게 된다.
Kibana
elasticsearch에서 만든 도구, data 시각화 및 탐색을 위한 도구이다.
kibana는 node js을 기반으로 한다. elasticsearch와 kibana 버전을 똑같이 해야한다. 아니면 호환성 문제나 실행이 안될 수가 있다.
visualize는 시각화 자료를 한번에 확인할 수 있는 페이지이다. 실습에는 로그 수집을 한 다음에 시각화를 하는 것에 집중을 해보겠다.
Logstash
Spring application이 있고 Elasticsearch, kibana가 있다고 하면 Logstash 다양한 데이터 소스에서 데이터를 수집하고 가공한 뒤
원하는 저장소로 전달하는 데이터 파이프라인 도구이다. 실습의 경우에는 spring application에서 발생한 로그를 elasticsearch로 밀어넣는다.
logstash는 spring application에서 발생한 로그를 Elasticsearch로 집어넣게 한다. logstash는 elasticsearch에 넣게 된다.
Docker로 elasticsearch 설치하기
컨테이너를 다루기 위해 도커 컴포즈 파일로 다룬다
- discovery.type : 서로를 찾는 것에 관한 설정
- single-node : 하나의 노드와 소통
name: elasticsearch

services:

  elasticsearch:
    container_name: elasticsearch
    image: elasticsearch:9.4.2
    ports:
      - "9200:9200"
    environment:
      - discovery.type=single-node
      - xpack.security.enabled=false
      - xpack.security.http.ssl.enabled=false

  kibana:
    container_name: kibana
    image: kibana:9.4.2
    ports:
       - "5601:5601"
    environment:
       - ELASTICSERACH_HOSTS=http://elasticsearch:9200

  logstash:
     container_name: logstash
     image: logstash:9.4.2
     ports:
        - "5000:5000"
     volumes:
        - ./libs/logstash.conf:/usr/share/logstash/pipeline/logstash.conf
이렇게 docker-compose.yml 파일을 실행하면 쉽게 도입하고 사용하는 것이 가능하다.
spring에서 발생한 로그를 elasticsearch로 밀어넣기 위해 파일로도 만들 수가 있다
→ 출력 채널을 만들 수가 있다. logstash로 로그출력을 할 수가 있다.
input{
    tcp{
        port => 5000
        codec => json_lines
    }
}

output{
    elasticsearch{
        hosts => ["elasticsearch:9200"]
        index => "spring-logs-%{+YYYY.MM.dd}"
    }
}